实在Agent在文献研究中的智能体实践:从“大海捞针”到“精准投喂”
一篇面向技术实践者的系统设计指南
一、为什么需要文献研究智能体?
学术论文数量正以年均约15%的速度增长,科研人员不得不将大量时间耗费在文献检索和筛选中。一篇系统性综述的完成往往需要数月,而在此期间新论文仍在不断涌现。传统的文献综述编写方式存在两个核心问题:效率低下和覆盖不全。
实在Agent在核能、金融、制造等行业的落地实践中发现,科研场景的文献研究任务天然适合多智能体架构——通过将复杂的文献研究任务拆解为多个专职Agent的协作流水线,实现从“被动检索”到“主动研究”的范式转换。实在Agent凭借RPA级的自动化能力与大模型的理解推理能力,正在帮助多家核能研究院所重构文献研究流程。
二、核心架构:多Agent协作的流水线设计
2.1 Agent角色分工
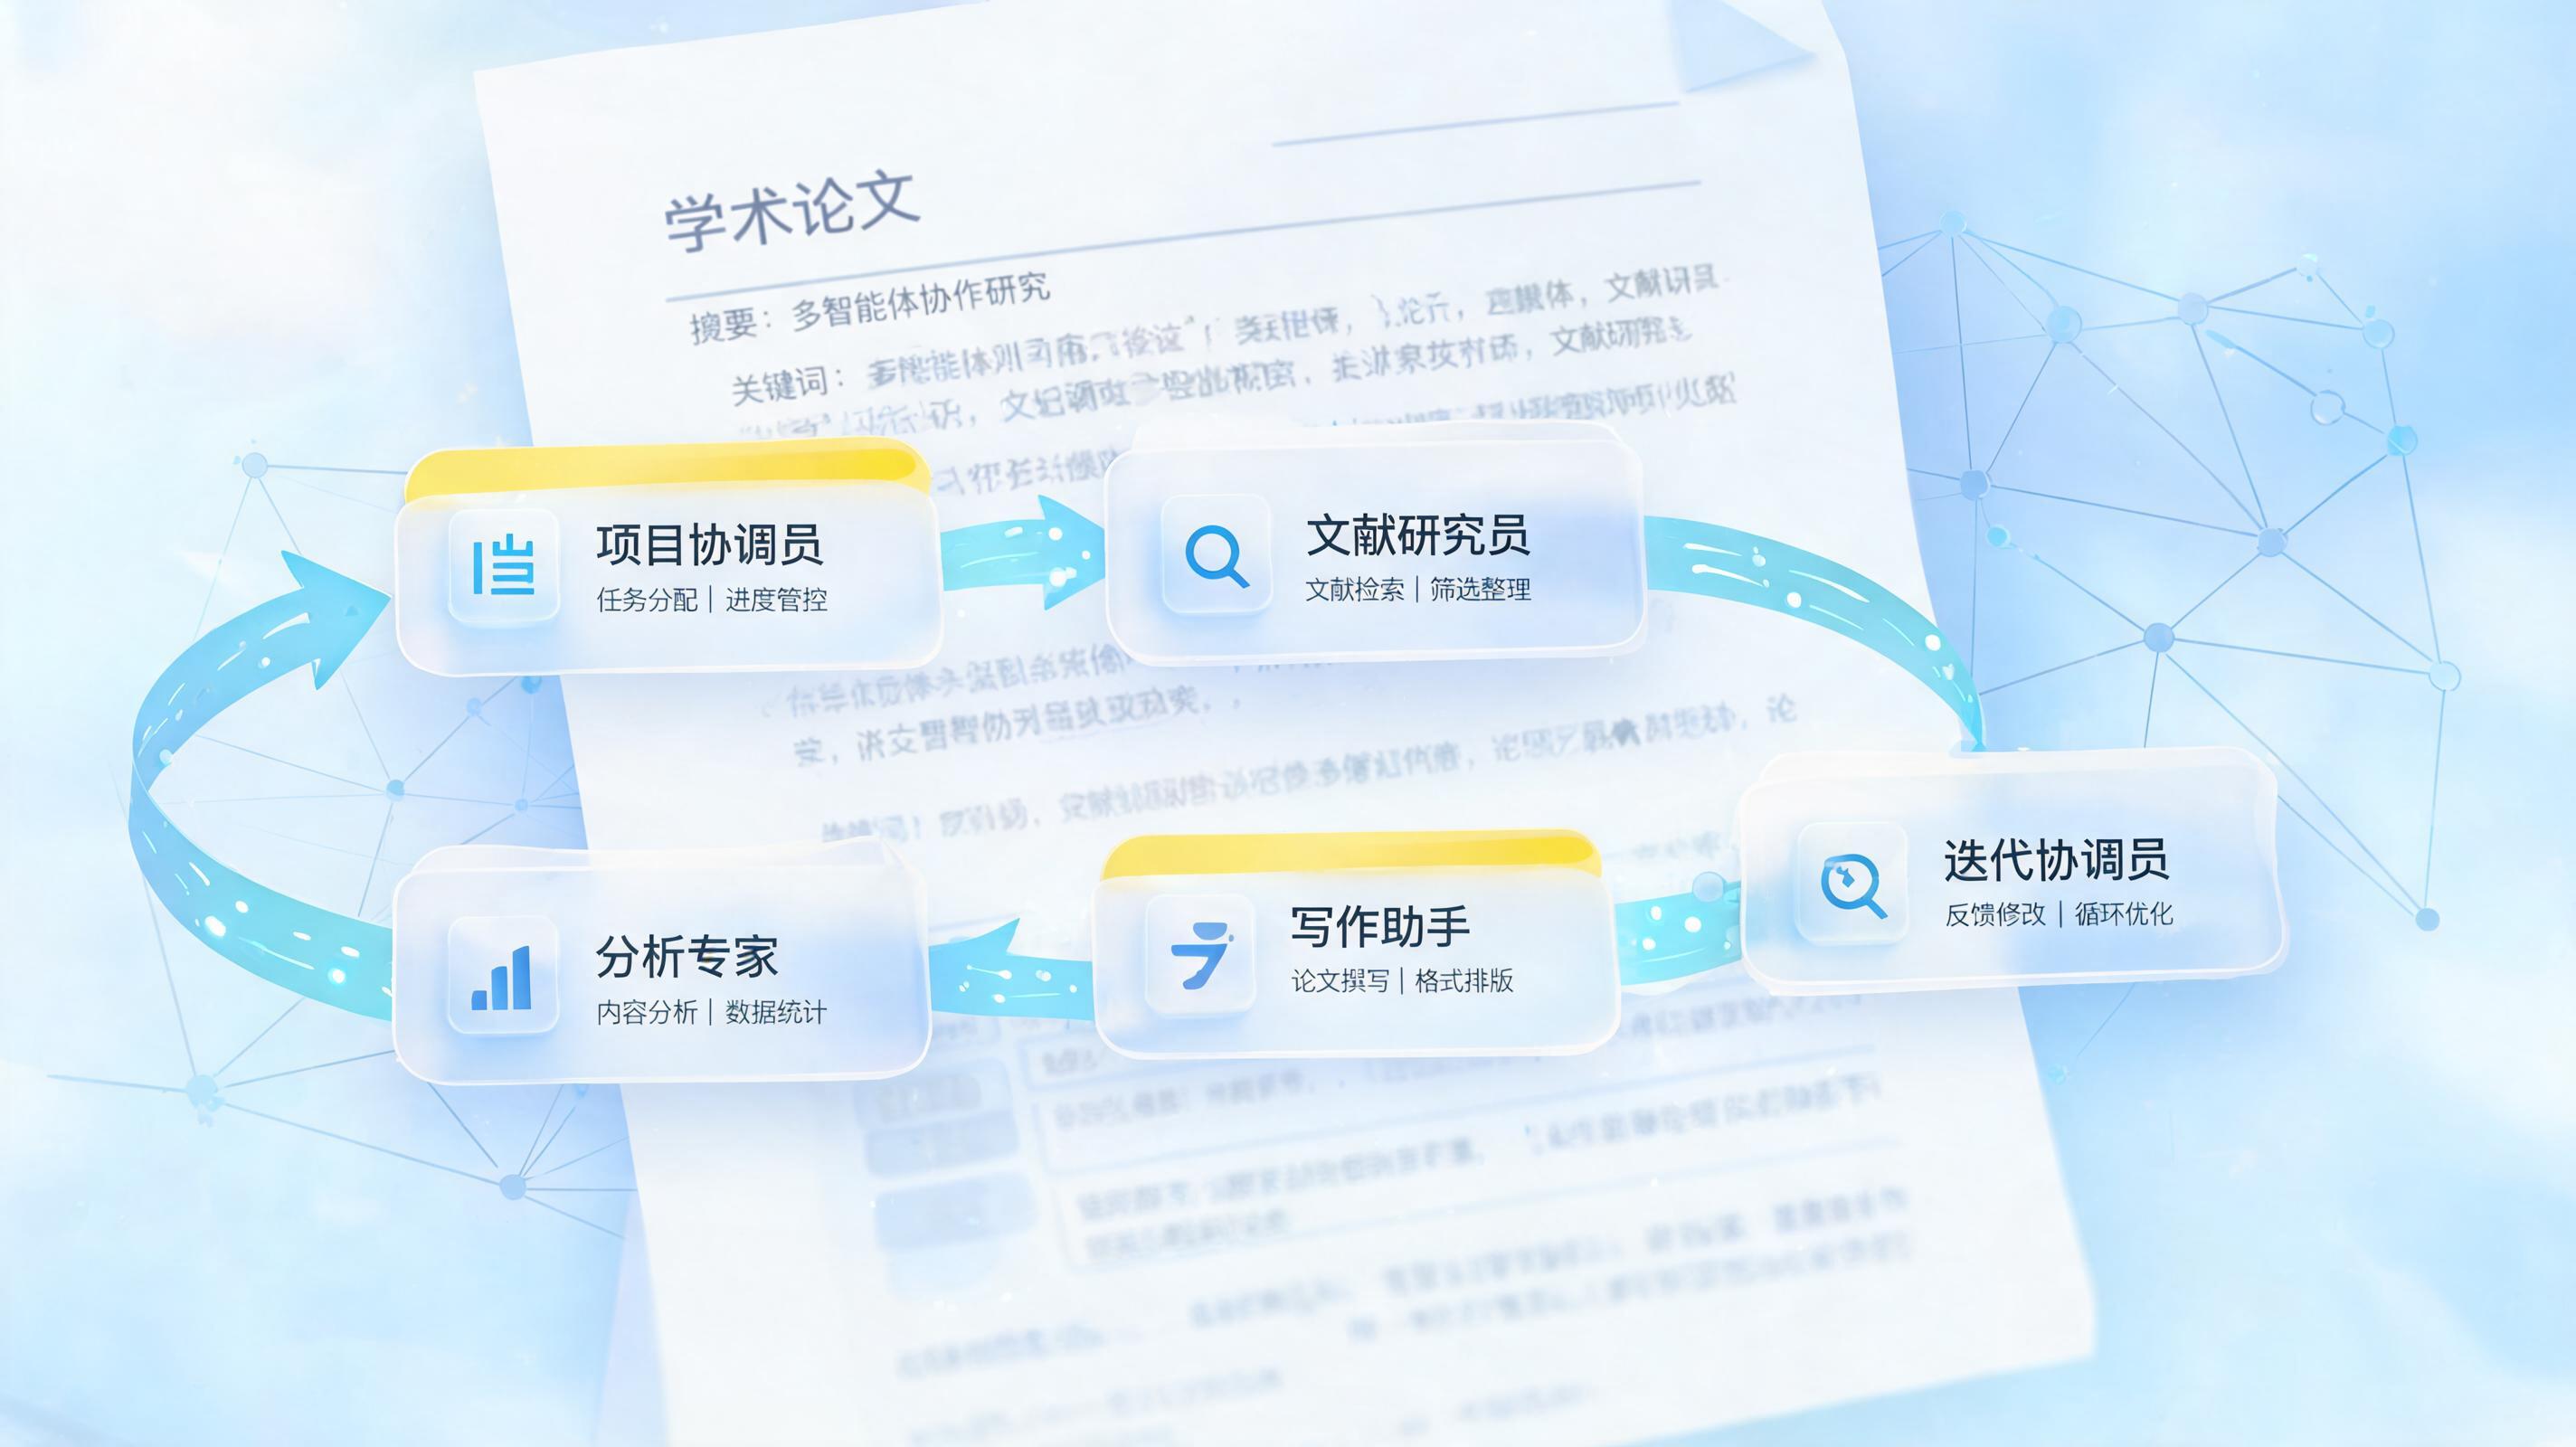
实在Agent在文献研究场景中采用多Agent协作架构,每个Agent承担明确的职能。参考业界前沿实践,一套完整的文献研究智能体通常包含以下角色:
- 项目协调员:负责任务规划与进度管理
- 文献研究员:负责检索与数据获取,从arXiv、OpenAlex、CrossRef和IEEE Xplore等API批量采集
- 分析专家:进行内容深度分析与缺口识别
- 写作助手:负责综述生成与结构化输出
- 迭代协调员:支持增量内容修订与质量评审
在实在Agent的落地实现中,这些角色被封装为可编排的智能体节点,通过可视化工作流进行调度。例如,实在Agent的“文献研究员”节点可自动监控指定数据库,定时批量下载PDF并入库;“分析专家”节点则调用知识图谱进行多跳推理。
2.2 知识图谱作为认知底座
知识图谱是文献研究智能体的核心认知基础设施。实在Agent在解析文献时,会从PDF集合中提取论文、概念、发现、方法和局限性作为类型化节点,并构建语义边(SUPPORTS、CONTRADICTS、EXTENDS),将非结构化的学术文本转化为可推理的知识网络。系统还支持时间分析,追踪概念趋势,检测上升/下降话题,并识别跨发表年份的复兴模式。
对于核能等专业领域,实在Agent还可结合行业知识库,构建领域特定的知识图谱,让文献中的技术脉络与工程经验形成关联,辅助研究人员快速定位关键文献。
2.3 混合RAG检索策略
单一的向量检索或图检索都有局限。实在Agent采用Agentic Hybrid RAG架构:一个自主Agent动态推理每个查询最适合的检索模式——GraphRAG还是VectorRAG——并实时调整生成策略以适配研究者需求。具体实现中,实在Agent根据查询复杂度选择图检索(通过Cypher查询知识图谱)或向量检索(结合稀疏和稠密检索加重排序)。
同时,实在Agent支持五种候选生成器并行运行——稠密向量(pgvector + HNSW)、Postgres全文搜索、知识图谱遍历、社区摘要和HyDE——然后通过加权倒数排名进行融合,确保检索结果的全面性和准确性。
三、工作流设计:从检索到输出的完整闭环
3.1 五阶段流水线
实在Agent的文献研究工作流通常遵循以下五个阶段:
阶段一:全域采集。 实在Agent的RPA能力在此发挥关键作用——自动监控学术数据库,定时批量获取最新文献,处理PDF解析、OCR识别、文本分块和Embedding生成。前端显示真实进度而不阻塞会话,让研究人员随时掌握采集状态。
阶段二:智能解析与知识构建。 多模态解析引擎提取论文中的实体、关系、方法和结论。实在Agent采用Deep-Reading Agent在文档级别将论文解构为层级化的“论文中心树”,系统性地分离出底层问题、方法论和实验结果。这些结构化信息被写入知识图谱,形成可持续复用的领域知识资产。
阶段三:深度分析与缺口识别。 Agent利用知识图谱进行多跳推理,识别研究空白。Critic Agent专门负责发现未被充分探索的研究方向,结合结构化综合、知识图谱建模和视角引导提问来增强综述的全面性和可追溯性。
阶段四:迭代式综述生成。 实在Agent内置检索员、分析师、作家和审稿人四个专职Agent,审稿人依据文献数量、结构完整性、语言质量等标准进行评分,不达标时自动将修改意见反馈给作家重写,直到质量达标。这种自动评审与迭代优化机制确保了输出质量的稳定性。
阶段五:洞察输出与交互。 最终输出不限于文本综述,还包括趋势分析看板、智能选题建议、文献智能问答和科研管理驾驶舱等多维成果。实在Agent已可实现对数千篇专业论文的深度检索与智能综述。
3.2 关键设计决策
Token成本控制。 实在Agent采用了一种务实的策略:Researcher将文献摘要压缩后写入State,Writer写完每章后生成轻量摘要供后续章节复用,而非传入全文,整体降低每次LLM调用的input token消耗。
引用保真机制。 实在Agent在引文准确性上追求近完美水平。核心思路是在系统提示中强制执行引用策略,Agent仅以“[Author, Year, PMID]”格式在文本中引用,同时Verifier Agent对每条引文进行数据库交叉验证。
人机协作验证。 实在Agent强调:“在设计工作流时,让每个论断从产生的那一刻起就携带支撑证据,而不是在完成草稿后再检查”。建议采用“AI建议、人类选择”的模式,保留研究者的策展人角色,同时设置明确的检查点进行人工验证。
四、技术选型与框架对比
当前主流的Agent编排框架各有侧重。AutoGen提供了灵活的对话式多Agent编排能力,适合需要复杂Agent间协商的场景。LangChain/LangGraph在工具调用和状态管理方面更加成熟,LangGraph的图结构特别适合表达文献研究中的条件分支和循环逻辑。CrewAI强调Agent角色的清晰定义和任务委托。
实在Agent在底层融合了RPA自动化能力与LLM推理能力,其编排引擎支持上述多种框架的集成。在检索层,向量数据库(如pgvector、ChromaDB)与图数据库(如Neo4j)的组合是当前主流方案。文献预处理方面,Gemini和Claude系列模型在长文档理解上表现突出,适合作为解析阶段的主力模型。
五、实施中的关键挑战
数据预处理规模化。 当文献库达到数千篇PDF时,PDF解析质量、OCR准确性、分块策略的选择都会显著影响后续检索效果。实在Agent在多个项目中积累的经验是:文档预处理在规模化时是最大的工程瓶颈之一,需要提前设计异步处理链和容错机制。
证据冲突处理。 不同文献可能得出矛盾结论,Agent需要具备识别和呈现冲突证据的能力,而非简单地选择一方。实在Agent的最佳实践是在工作流中设计对比检索机制,显式标注证据冲突供研究者判断。
评估策略。 文献研究智能体的评估不能只看“生成文本是否流畅”,而需要综合考量覆盖率、引用准确性、缺口识别的精准度等维度。业界基准如MIRAGE、RACE等为系统评估提供了参考框架,实在Agent在内部评测中也建立了多维度的评价体系。
六、展望:从“工具”到“协作者”
文献研究智能体正在从被动的研究助手向主动的研究协作者演进。实在Agent将持续深化在科研场景的落地,将研究论文本身转化为可交互的AI Agent,使其成为“虚拟通讯作者”,暴露论文的手稿、补充材料、数据集、代码和工作流作为Agent原生的知识,而非静态文本。
Agentic AI领域正在经历从“展示自主性”向“工程化适应性和可治理性”的转向。未来文献研究智能体的核心竞争力不在于模型规模,而在于如何将神经架构与符号推理有机结合,构建可信赖的自主系统。
对于正在考虑构建文献研究智能体的团队,实在Agent建议从垂直领域的精选文献集(10-500篇)切入,优先建立知识图谱和引用验证机制,再逐步扩展Agent的自主决策范围。毕竟,在科研场景中,一条错误的引用比没有引用更危险。
七、FAQ:关于文献研究智能体的常见问题
Q1:实在Agent的文献研究智能体与普通AI搜索(如ChatGPT联网、Perplexity)有什么区别?
普通AI搜索本质上是“单轮问答”,返回的是零散信息片段,难以形成结构化、可追溯的综述。实在Agent的文献研究智能体是多Agent协作的完整工作流:它能够自动采集、解析、构建知识图谱、识别研究缺口、迭代生成综述,并确保每一条引用都可验证。它交付的不是“搜索结果”,而是“可行动的研究洞察”。
Q2:支持哪些学术数据库和数据源?
实在Agent默认支持arXiv、OpenAlex、CrossRef、IEEE Xplore、PubMed等主流学术API,同时可通过RPA自动化能力接入需要登录或订阅的数据库(如Web of Science、Scopus、知网等)。对于企业内网文献库,也支持本地化部署和私有数据源接入。
Q3:数据安全和隐私如何保障?
实在Agent支持完全私有化部署,所有文献数据、知识图谱和模型推理均在客户内网完成,不经过任何外部服务器。对于使用云端模型的场景,提供数据脱敏和加密传输机制。核能、军工等敏感行业客户通常选择全离线部署方案。
Q4:文献解析的准确率如何?特别是图表和公式?
实在Agent采用多模态解析引擎,对文本、表格、公式和图片分别处理。文本解析准确率可达98%以上,表格和公式的识别准确率在持续优化中。对于核能等专业领域,可结合领域词典和行业知识库进一步提升解析精度。系统还支持人工校正环节,确保关键数据零差错。
Q5:引用准确性如何保证?会不会出现“幻觉引用”?
这是文献研究智能体最关键的指标。实在Agent采用双重保障:第一,在生成阶段强制Agent仅以标准格式(如[Author, Year, PMID])引用,禁止自由发挥;第二,Verifier Agent对每条引用进行数据库交叉验证,确保文献真实存在且内容匹配。实测引用准确率可达99%以上。
Q6:部署和实施周期一般多长?
对于标准场景(10-500篇精选文献集),实在Agent通常在2-4周内完成部署和调优。对于大规模文献库(数千篇以上)或需要深度定制知识图谱的领域,实施周期约为6-8周。实在Agent提供可视化工作流编排界面,业务人员经过培训后可自行调整Agent流程。
Q7:如何评估文献研究智能体的效果?
建议从四个维度评估:覆盖率(是否遗漏关键文献)、引用准确性(引用是否真实可验证)、缺口识别精准度(发现的研究空白是否有价值)、以及人机协作效率(科研人员节省的时间)。实在Agent在内部评测中建立了多维评价体系,也可根据客户需求定制评估指标。
Q8:未来会支持多语言文献和跨语言综述吗?
实在Agent已支持中英文文献的混合检索与解析,跨语言综述生成功能正在内测中。未来将逐步扩展至日文、德文、俄文等核能领域常用语种,帮助研究人员打破语言壁垒,获取全球前沿成果。