健康险医疗单据智能录入:OCR识别+目录对码自动化技术指南
2026-09-17 16:13:47阅读 2
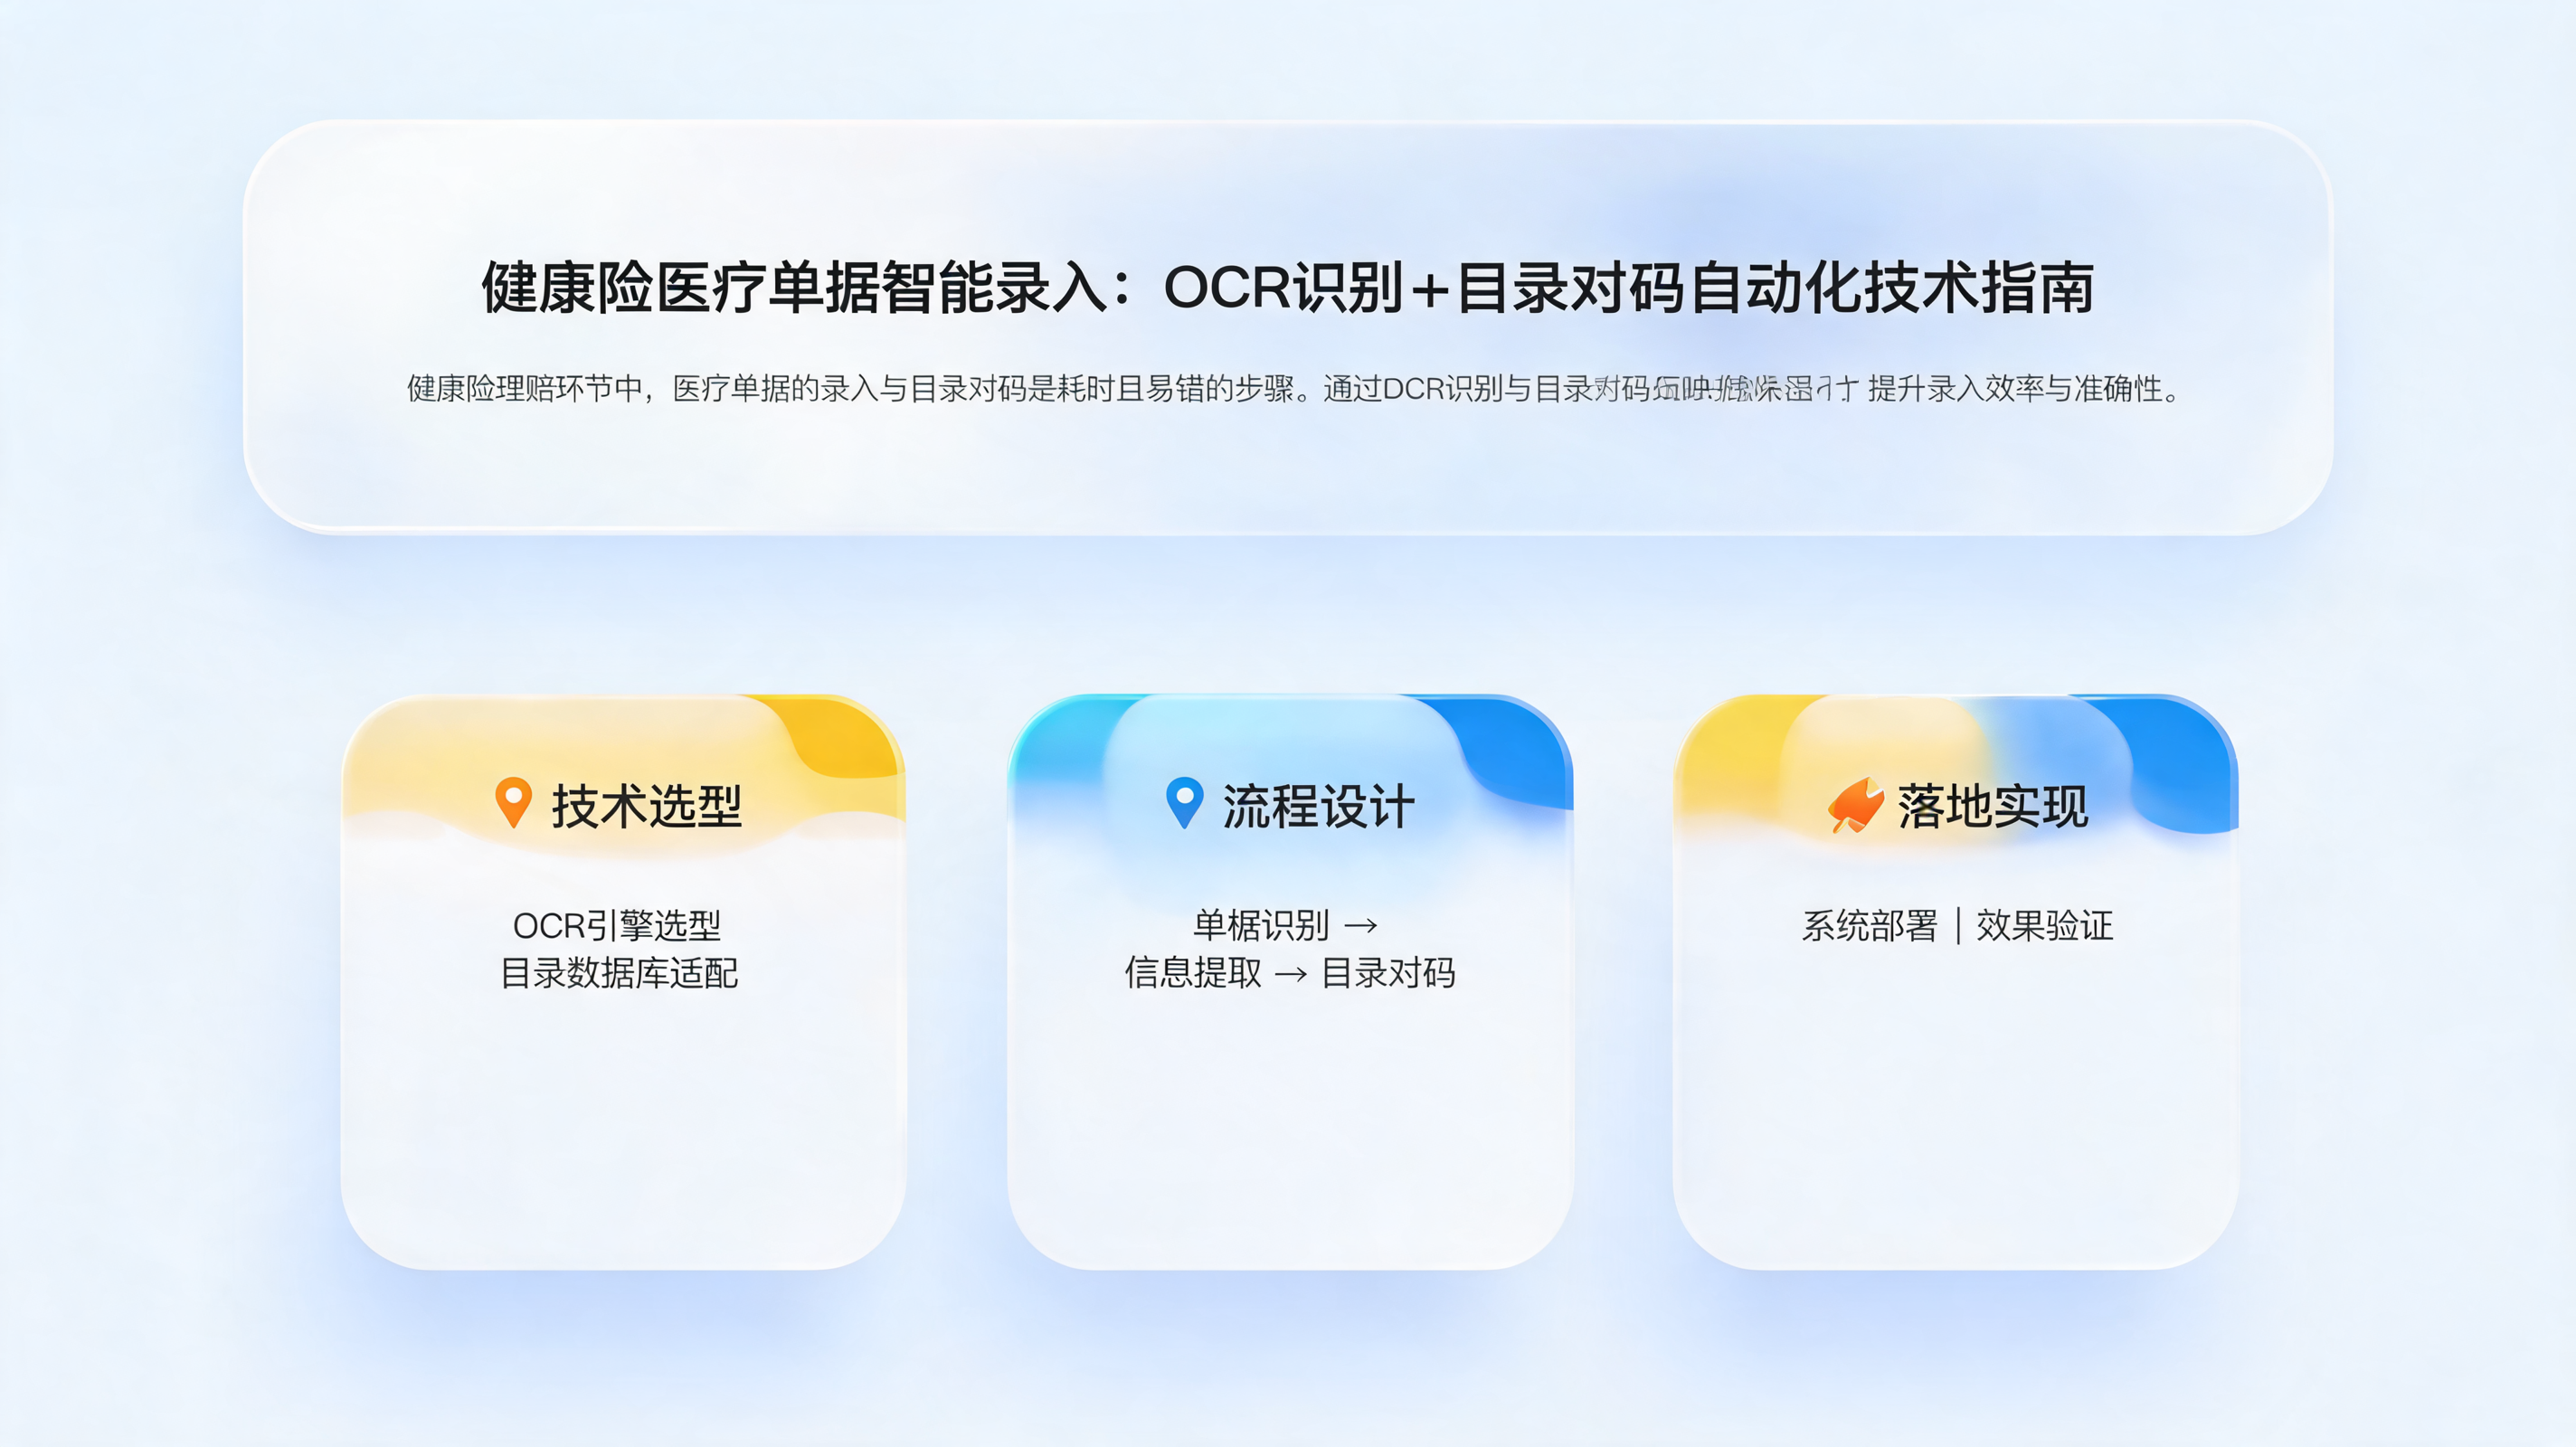
健康险理赔环节中,医疗单据的录入与目录对码是耗时且易错的步骤。本文介绍如何通过OCR识别与目录对码自动化技术,将纸质或电子单据中的关键信息提取并映射至保险目录,从而提升录入效率与准确性。以下从技术选型、流程设计到落地实现逐步展开。
一、整体流程概述
医疗单据智能录入的核心流程分为三步:
- 单据预处理:图像去噪、旋转校正、版面分析。
- OCR识别:提取文字与结构化字段(如药品名、金额、日期)。
- 目录对码:将识别结果与保险目录(药品、诊疗项目、耗材)进行匹配,输出标准编码。
整个流程可通过异步任务队列串联,单张单据处理时间通常控制在2秒以内。
二、OCR识别模块的关键实现
2.1 图像预处理
使用OpenCV进行基础处理,示例命令:
pip install opencv-python pillow常见操作包括灰度化、二值化、去噪(高斯模糊)、透视校正。对于拍照倾斜的单据,可先通过轮廓检测找到文档边缘并做透视变换。
2.2 OCR引擎选型
推荐组合:
- 通用文字:PaddleOCR(中文识别效果好,支持表格结构)。
- 票据专用:使用微调后的模型,或调用云服务(如百度OCR、腾讯云OCR)的医疗票据接口。
本地部署PaddleOCR的代码片段:
from paddleocr import PaddleOCR
ocr = PaddleOCR(use_angle_cls=True, lang='ch')
result = ocr.ocr('medical_bill.jpg', cls=True)
for line in result[0]:
    print(line[1][0])  # 文本内容
2.3 结构化字段提取
OCR输出为文本行后,需按单据类型提取关键字段。常用方法:
- 正则匹配:针对“金额”“日期”“药品名”等固定模式。
- 关键锚点定位:例如“合计”“医保编码”后的数值。
- 表格识别:若单据为表格,使用PaddleOCR的
structure模块或layoutparser还原行列关系。
建议将提取结果存入JSON,便于后续对码:
{
  "drug_name": "阿莫西林胶囊",
  "spec": "0.25g*24粒",
  "amount": 28.50,
  "date": "2025-03-12"
}
三、目录对码自动化
3.1 目录数据准备
保险目录通常包含三列:标准编码、标准名称、别名/商品名。需预先导入数据库(如PostgreSQL或Elasticsearch)。示例表结构:
CREATE TABLE insurance_catalog (
    code VARCHAR(32) PRIMARY KEY,
    standard_name VARCHAR(255),
    aliases TEXT[]
);
3.2 匹配策略
采用多级匹配,优先级从高到低:
- 精确匹配:识别名称与目录标准名或别名完全一致。
- 模糊匹配:使用编辑距离(Levenshtein)或Jaro-Winkler,阈值建议0.85。
- 语义匹配:对未命中项,用嵌入模型(如text2vec)计算余弦相似度,取Top1且分数>0.9。
- 规则兜底:根据剂型、规格、厂商进行组合过滤。
Python示例(使用rapidfuzz):
from rapidfuzz import process, fuzz
choices = ["阿莫西林胶囊", "阿莫西林颗粒", "布洛芬片"]
name = "阿莫西林胶嚢"  # 识别错字
match, score, idx = process.extractOne(name, choices, scorer=fuzz.ratio)
if score > 85:
    print(f"匹配到: {match}, 分数: {score}")
3.3 对码结果校验
- 置信度阈值:低于阈值的结果标记为“待人工复核”。
- 冲突检测:同一单据中相同药品出现不同编码时触发告警。
- 日志记录:保存原始识别文本、匹配候选、最终编码,便于审计与模型迭代。
四、系统集成与性能优化
4.1 服务化部署
将OCR与对码封装为REST API,使用FastAPI:
from fastapi import FastAPI, UploadFile
app = FastAPI()

@app.post("/process_bill")
async def process_bill(file: UploadFile):
    # 调用OCR与对码逻辑
    return {"code": "A001", "confidence": 0.96}
启动命令:
uvicorn main:app --host 0.0.0.0 --port 80004.2 缓存与并发
- 对高频药品名称建立Redis缓存,减少数据库查询。
- 使用Celery或RQ将OCR任务异步化,避免阻塞主线程。
- 批量处理时,可对图像进行分片并行识别。
4.3 监控与迭代
- 记录每日对码成功率、平均耗时、人工复核率。
- 定期用新单据微调OCR模型,并更新目录别名库。
五、常见问题与应对
- 识别错字导致对码失败:增加拼音纠错或同音字替换预处理。
- 单据版式多样:按医院或单据类型训练专用OCR模板。
- 目录更新频繁:设计增量同步机制,支持热更新别名表。
- 隐私与合规:本地化部署OCR,避免敏感医疗数据外传;传输层使用HTTPS。
通过上述步骤,可构建一套稳定、可扩展的健康险医疗单据智能录入系统,将人工录入工作量降低70%以上,同时提升对码一致性。