保险全量智能质检:通话录音ASR转写+违规话术识别技术指南
保险全量智能质检是指对客服通话录音进行全量ASR转写,再通过违规话术识别模型自动检测销售误导、承诺收益等违规行为。其核心价值在于将传统抽检覆盖率从不足5%提升至100%,并统一判定标准。本文从音频预处理、ASR转写、话术识别到系统集成,逐步说明工程实现要点。
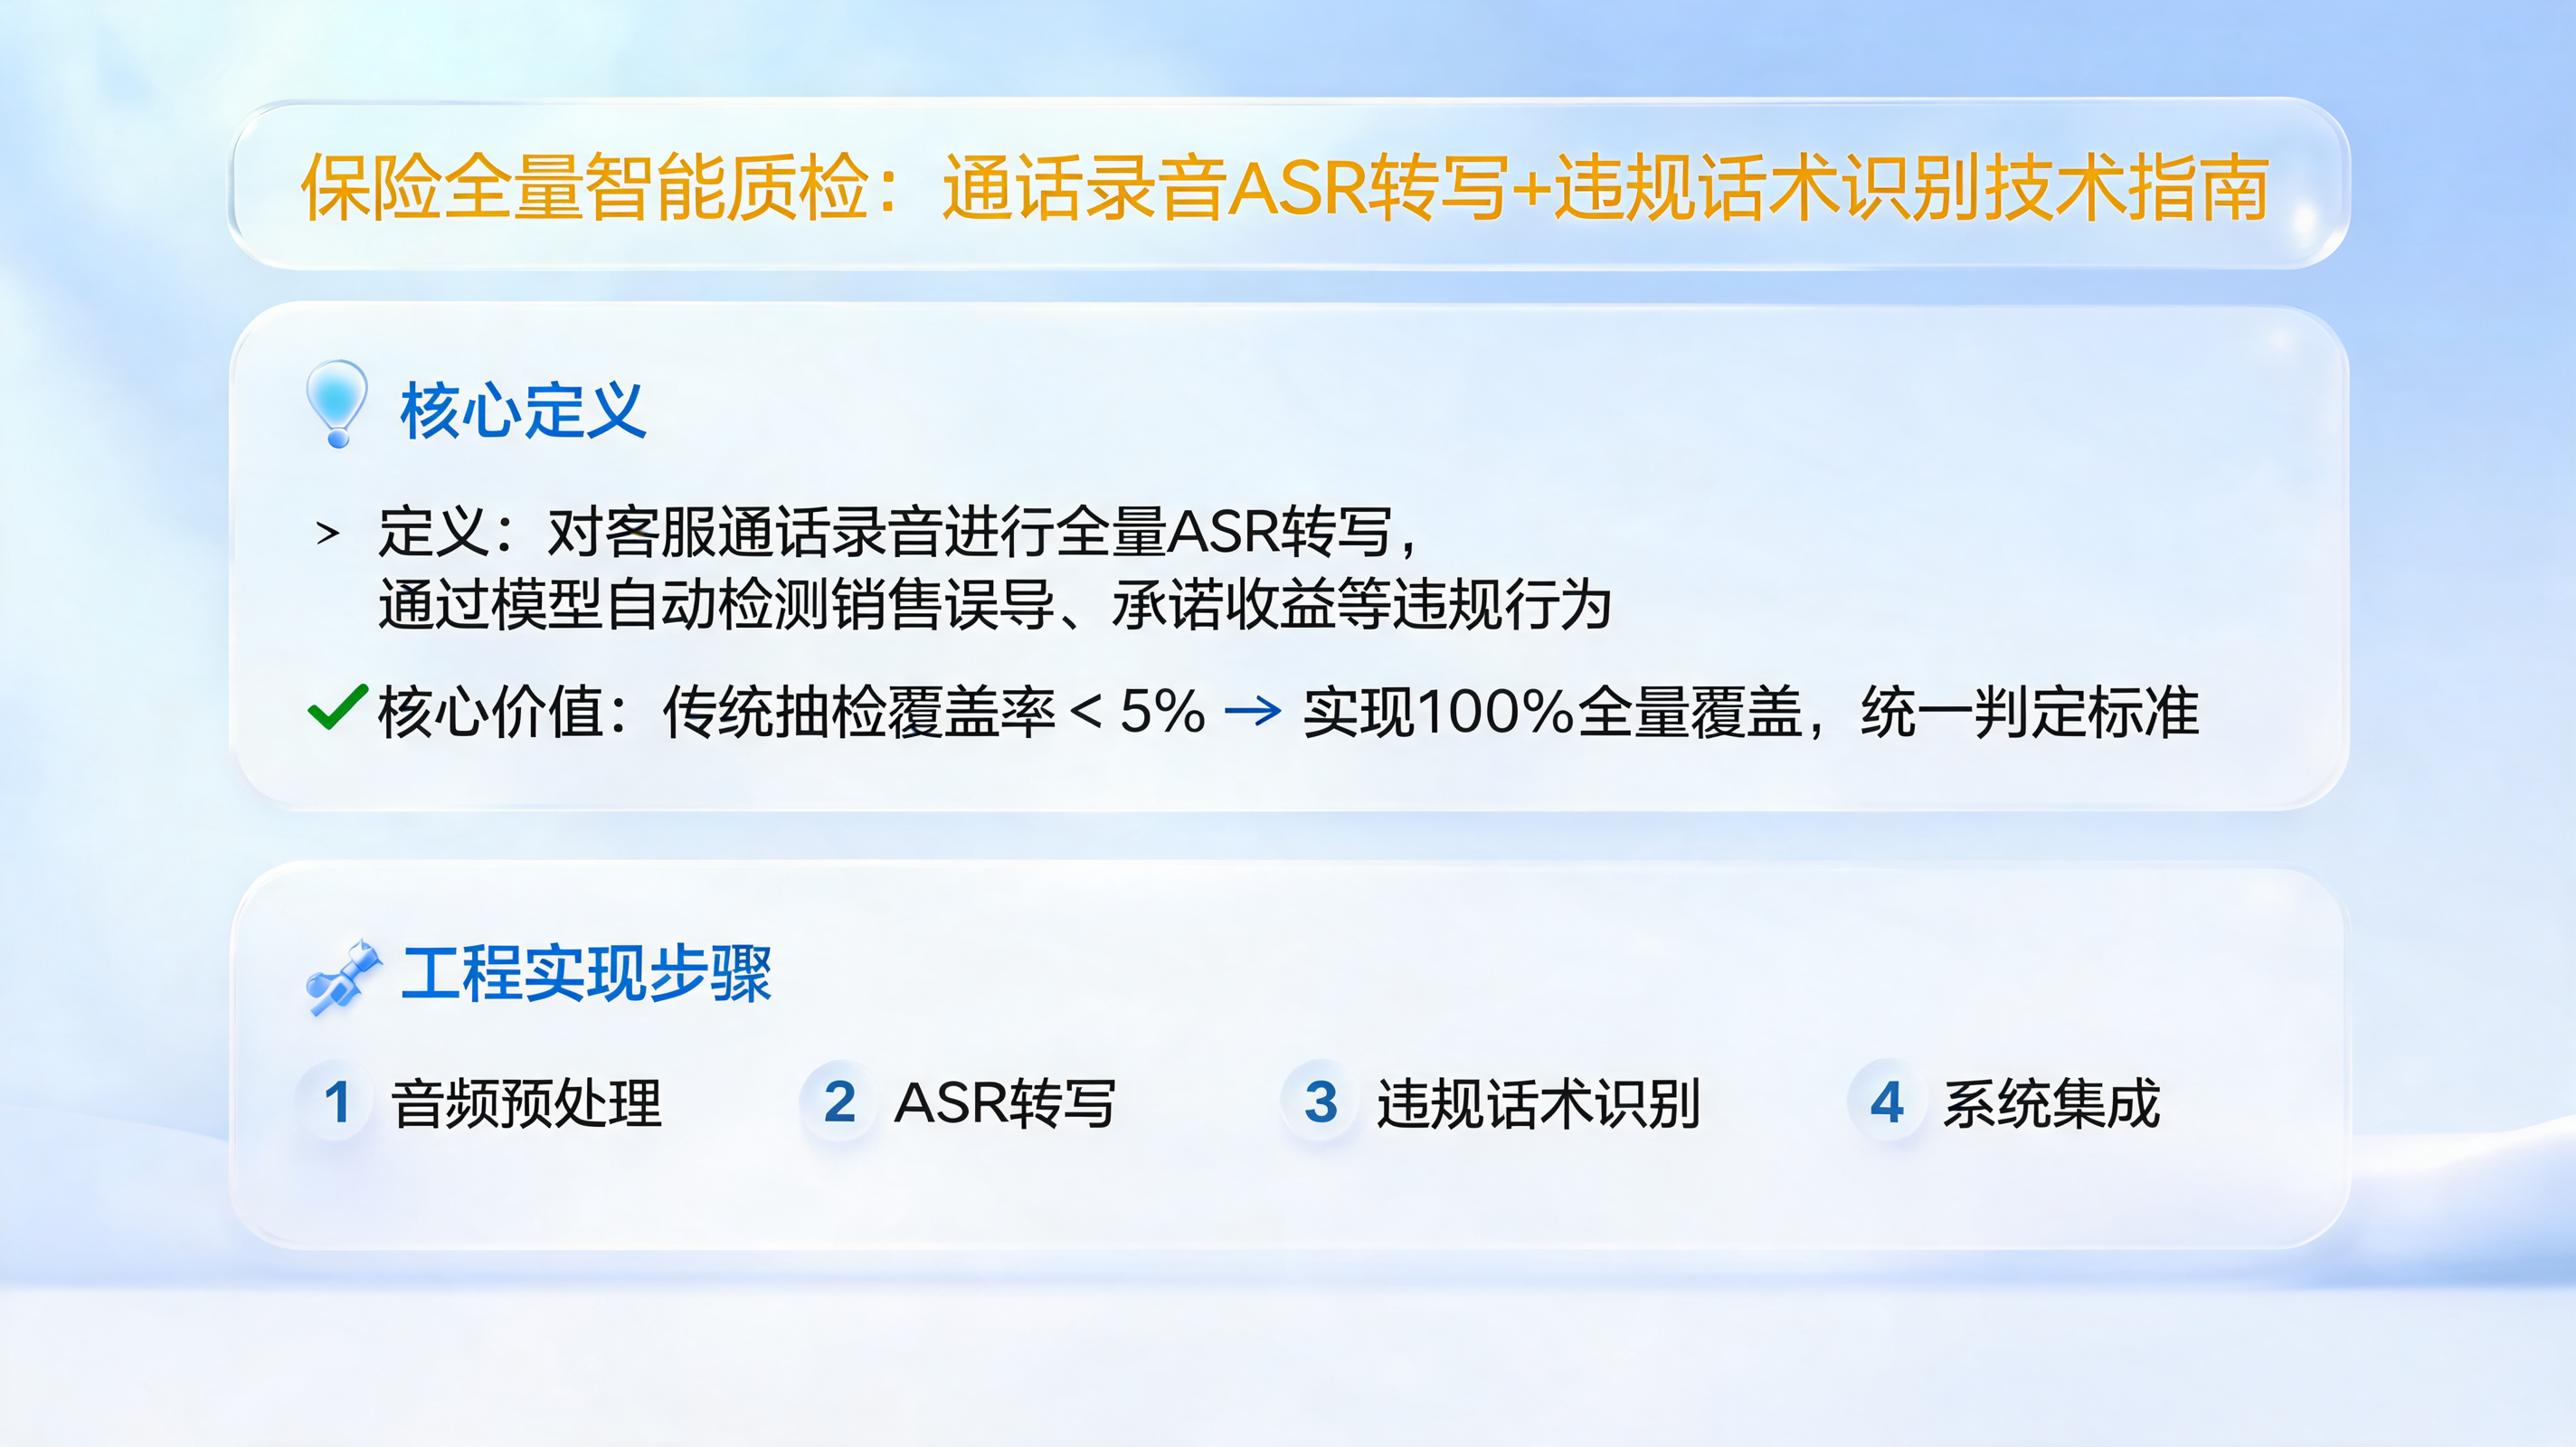
一、整体流程与数据流
典型处理链路如下:
录音文件 → 音频预处理 → ASR转写 → 文本后处理 → 违规话术识别 → 质检结果入库关键路径:录音存储(如 /data/recordings/{date}/{agent_id}.wav)→ 转写服务(HTTP端口 8080)→ 规则/模型引擎(gRPC端口 50051)→ 质检数据库(MySQL 3306)。
全量质检需支持每日数万小时音频,建议采用消息队列(如 Kafka 9092)解耦各阶段,避免阻塞。
二、音频预处理:统一格式与降噪
原始录音常存在采样率不一、双声道分离、背景噪声等问题。预处理步骤:
- 格式归一:统一转为 16kHz、16bit、单声道 WAV。使用
ffmpeg命令:ffmpeg -i input.mp3 -ar 16000 -ac 1 -sample_fmt s16 output.wav - 静音切除:去除首尾静音段,减少无效转写。可用
sox或webrtcvad。 - 降噪:对噪声明显的录音,采用谱减法或 RNNoise。注意降噪过度会损伤语音,建议先在小样本上验证。
对于双声道录音(客服与客户各一声道),可分别转写后再按时间戳合并,提升角色区分准确率。
三、ASR转写:选型与热词优化
ASR转写准确率直接影响后续违规识别。建议:
- 引擎选型:优先支持流式与离线批量转写的开源方案(如 FunASR、Whisper)或云服务。离线批量场景下,Whisper large-v3 中文准确率较高,但需 GPU 资源。
- 热词表:保险领域专有名词(如“增额终身寿”“万能账户”“保证续保”)需加入热词表,提升识别率。例如在 FunASR 中配置:
{"热词": ["增额终身寿", "万能账户", "保证续保", "现金价值"]} - 标点与顺滑:转写后需加标点、去除“嗯”“啊”等填充词,便于规则匹配。可使用标点恢复模型。
转写结果建议按句或按时间片(如每30秒)输出,并保留原始时间戳,便于后续定位违规片段。
四、违规话术识别:规则与模型结合
违规话术通常分为两类:硬性违规(如承诺收益、夸大保障)和软性违规(如误导性对比、隐瞒免责)。推荐规则引擎 + 文本分类模型结合。
规则引擎:针对明确关键词和句式。例如:
- 承诺收益:
保证.*收益|稳赚不赔|年化.*% - 夸大保障:
什么都赔|全部报销|零免赔 - 隐瞒免责:
不用看免责|免责条款不重要
使用正则表达式匹配时,注意上下文窗口。例如“保证收益”出现在“不能保证收益”中应排除,可引入否定词检测。
文本分类模型:对规则难以覆盖的变体,采用微调 BERT 或 ERNIE 做多标签分类。标注数据可从历史质检记录中抽取正负样本。输入为转写文本片段(如单句或滑动窗口),输出违规类别及置信度。建议阈值设为 0.85,低于阈值转人工复核。
后处理:合并相邻违规片段,生成质检报告,包含违规类型、时间戳、原文摘录、置信度。
五、系统集成与性能优化
全量质检需处理海量音频,工程上注意:
- 批处理与并发:ASR 转写用 GPU 批处理,每批 8-16 条音频。规则引擎用多进程,模型推理用 TensorRT 或 ONNX Runtime 加速。
- 缓存与去重:相同录音文件(MD5 相同)只转写一次。
- 监控指标:转写延迟(P99 < 5 分钟/小时音频)、违规召回率、误报率。建议每日抽样人工复核 1% 结果,持续优化规则和模型。
- 存储:转写文本与质检结果存入 Elasticsearch,便于按坐席、日期、违规类型检索。
六、常见问题与调优建议
- ASR 错误导致漏检:如“保证收益”被转成“保证收一”。可加入拼音相似匹配或使用 ASR 置信度过滤低质量片段。
- 方言与口音:若坐席口音重,需在 ASR 微调时加入对应方言数据。
- 规则冲突:多条规则命中同一片段时,按优先级输出(硬性违规 > 软性违规)。
- 模型漂移:每季度用新数据重新微调分类模型,保持召回率稳定。
整体而言,保险全量智能质检的关键在于 ASR 准确率与违规识别的召回率平衡。建议先跑通小规模闭环,再逐步扩大音频量,持续迭代规则与模型。