企业AI落地的四大困惑与Agent系统化破局指南
企业AI落地,本质上是把模型能力嵌入真实业务流程、并持续产出可衡量价值的过程,而不是一次性的模型采购或演示。 本文先拆解企业在落地过程中最常卡住的四个困惑——数据基础、价值量化、组织协同与工程化交付,随后结合实际的技术架构,聊聊如何通过企业级Agent平台系统化地跨越这些障碍。

一、数据之困:模型换了一轮,答案还是不对
很多团队的第一反应是“模型不行”,但更常见的根因在数据侧:口径不统一、元数据缺失、权限体系残缺,导致同一个问题在不同部门得到不同答案。
行动步骤:
1. 从“最小数据集”开始,而不是全量治理。 选定一个具体任务(例如“生成报价单”),只找出完成这个任务所必需的那几个数据源。不要一开始就试图把全公司数据都梳理干净。
2. 先把“同一个词”的定义对齐。 “销售额”含不含税?“回款率”的分母是什么?把核心指标的计算口径、取数来源固化成一份业务字典。
3. 补全元数据,让 AI 从“猜”变成“查”。 仅有表名和字段类型不够,还需要字段的业务含义、更新频率、上下游关联。缺少这些,模型只能靠字段名硬猜。
4. 建一条轻量的质量检测链路。 先对 AI 要用的核心字段做空值、唯一性、范围校验,并放入每日任务。
# 示意:对进入知识库前的关键字段做基础校验
python check_pipeline.py --table product_price \
  --rules "price>0, sku_not_null, currency_in(CNY,USD)"
二、价值之困:ROI 算不清,预算就批不下来
企业 AI 支出在快速增长,但相当比例的组织难以从中提取可衡量的业务价值。常用的“节省时间 × 时薪”估算方式经常高估收益、低估返工与协调成本,导致业务和财务在评审时各说各话。
行动步骤:
1. 先定义“可观测的验收指标”。 处理时长、人工介入比例、差错率、一次通过率,这些指标在项目启动时就应该明确,基线数据提前采集。
2. 在应用层做“任务级计量”。 不要只看 token 消耗量。给每类任务打上成本标签,记录“这类任务平均消耗多少资源、耗时多少、需要人工介入几次”,跑一个月,单任务成本才有说服力。
3. 算总成本,而不是局部单价。 总成本应包括模型调用、系统运维、人工检查、返工和跨部门协调的时间。
4. 把“成熟应用”和“探索项目”分开评价。 探索项目可以暂时没有收入,但必须带来有用的信息。混在一起考核,两类都会变形。
三、组织之困:AI 不是 IT 一个部门的事
技术团队做出了工具,业务团队不用;业务团队提的需求,技术团队觉得不可行。最终 AI 变成“外挂”,和真实业务流程两张皮。
行动步骤:
1. 设一个跨职能小队。 至少包含业务侧的关键用户、IT 侧的工程能力和数据侧的支持。牵头人需要有权限协调流程和资源。
2. 用一个“速赢”场景建立信任。 选择边界清晰、高频、结果可验证的场景,在 4—8 周内跑出可展示的效率提升。
3. 把工具和权限交到业务侧。 如果每一个 AI 应用都要排 IT 的队,落地速度永远跟不上业务变化。提供低门槛的搭建工具和培训是关键。
4. 流程和考核要同步改。 如果审批节点、岗位职责还是 AI 出现之前的那一套,单点效率提升会被组织惯性吃掉。
四、工程之困:从“能演示”到“能交付”
演示环境里跑通和在生产环境稳定运行之间,有一道容易被低估的沟。典型卡点集中在:输出不可验证、异常处理无人兜底、技术选型在“先验证”和“后规模”之间错配。
行动步骤:
1. 选型遵循“先验证、后规模”。 数据敏感度中等时,优先用 API 快速验证;只有当数据不允许出内网、或调用量达到阈值时,才进入私有化部署评估。不要在场景没验证时就被基础设施绑死。
2. 强制结构化输出。 要求 AI 输出固定字段结构(CSV、JSON、表格),下游才能用脚本做字段级校验,这是输出能进入审批流的前提。
3. 为异常设计兜底和熔断。 提前定义:哪些情况自动重试、哪些降级到规则或人工、哪些输出直接阻断。
4. 把合规与安全做成工程组件。 资产盘点、身份映射、PII 实时检测与脱敏、全链路审计,需要在架构阶段就作为模块嵌入。
五、破局思路:以 Agent 双引擎承接业务闭环
面对上述的数据、ROI、组织和工程化难题,单靠一个基座模型是不够的。目前业界的一种解法是采用认知与执行双引擎协同的企业级 Agent 平台(如实在智能的 TARS 大模型与 Agent 架构),其落地思路可以为我们提供参考。
1. 用“双引擎”打通工程与数据堵点
认知 Agent(大脑)负责多源信息理解、构建知识库、规则判断与结果生成;执行 Agent(RPA/API)负责跨系统协同、自动填单、数据回写。配合企业知识库(RAG),让 AI 结合企业内部业务规则来作答,减少“幻觉”和口径不一的问题。
2. 用“技能沉淀”解决组织复用难题
不要把 AI 做成一次性开发。通过低代码编排,业务人员也能把日常的文档处理、数据分析封装成“企业级技能”。这些技能由大模型动态调用,既沉淀了个人经验,又降低了开发门槛。
3. 用 FDE 驻场模式保障 ROI 落地
在交付环节,前端部署工程师(FDE)驻场一线,能够精准识别高价值场景,并在短时间内完成 POC。跑通后,再通过“企业大脑”进行规模化复制和权限管控,把账算明白后再扩大投入。
落地案例(脱敏参考):
- 财务审核场景:某能源央企利用 实在Agent 结合 OCR 和大模型,自动提取业务招待单据内容,并通过大模型生成代码公式进行规则校验,减少了人工核对时间。
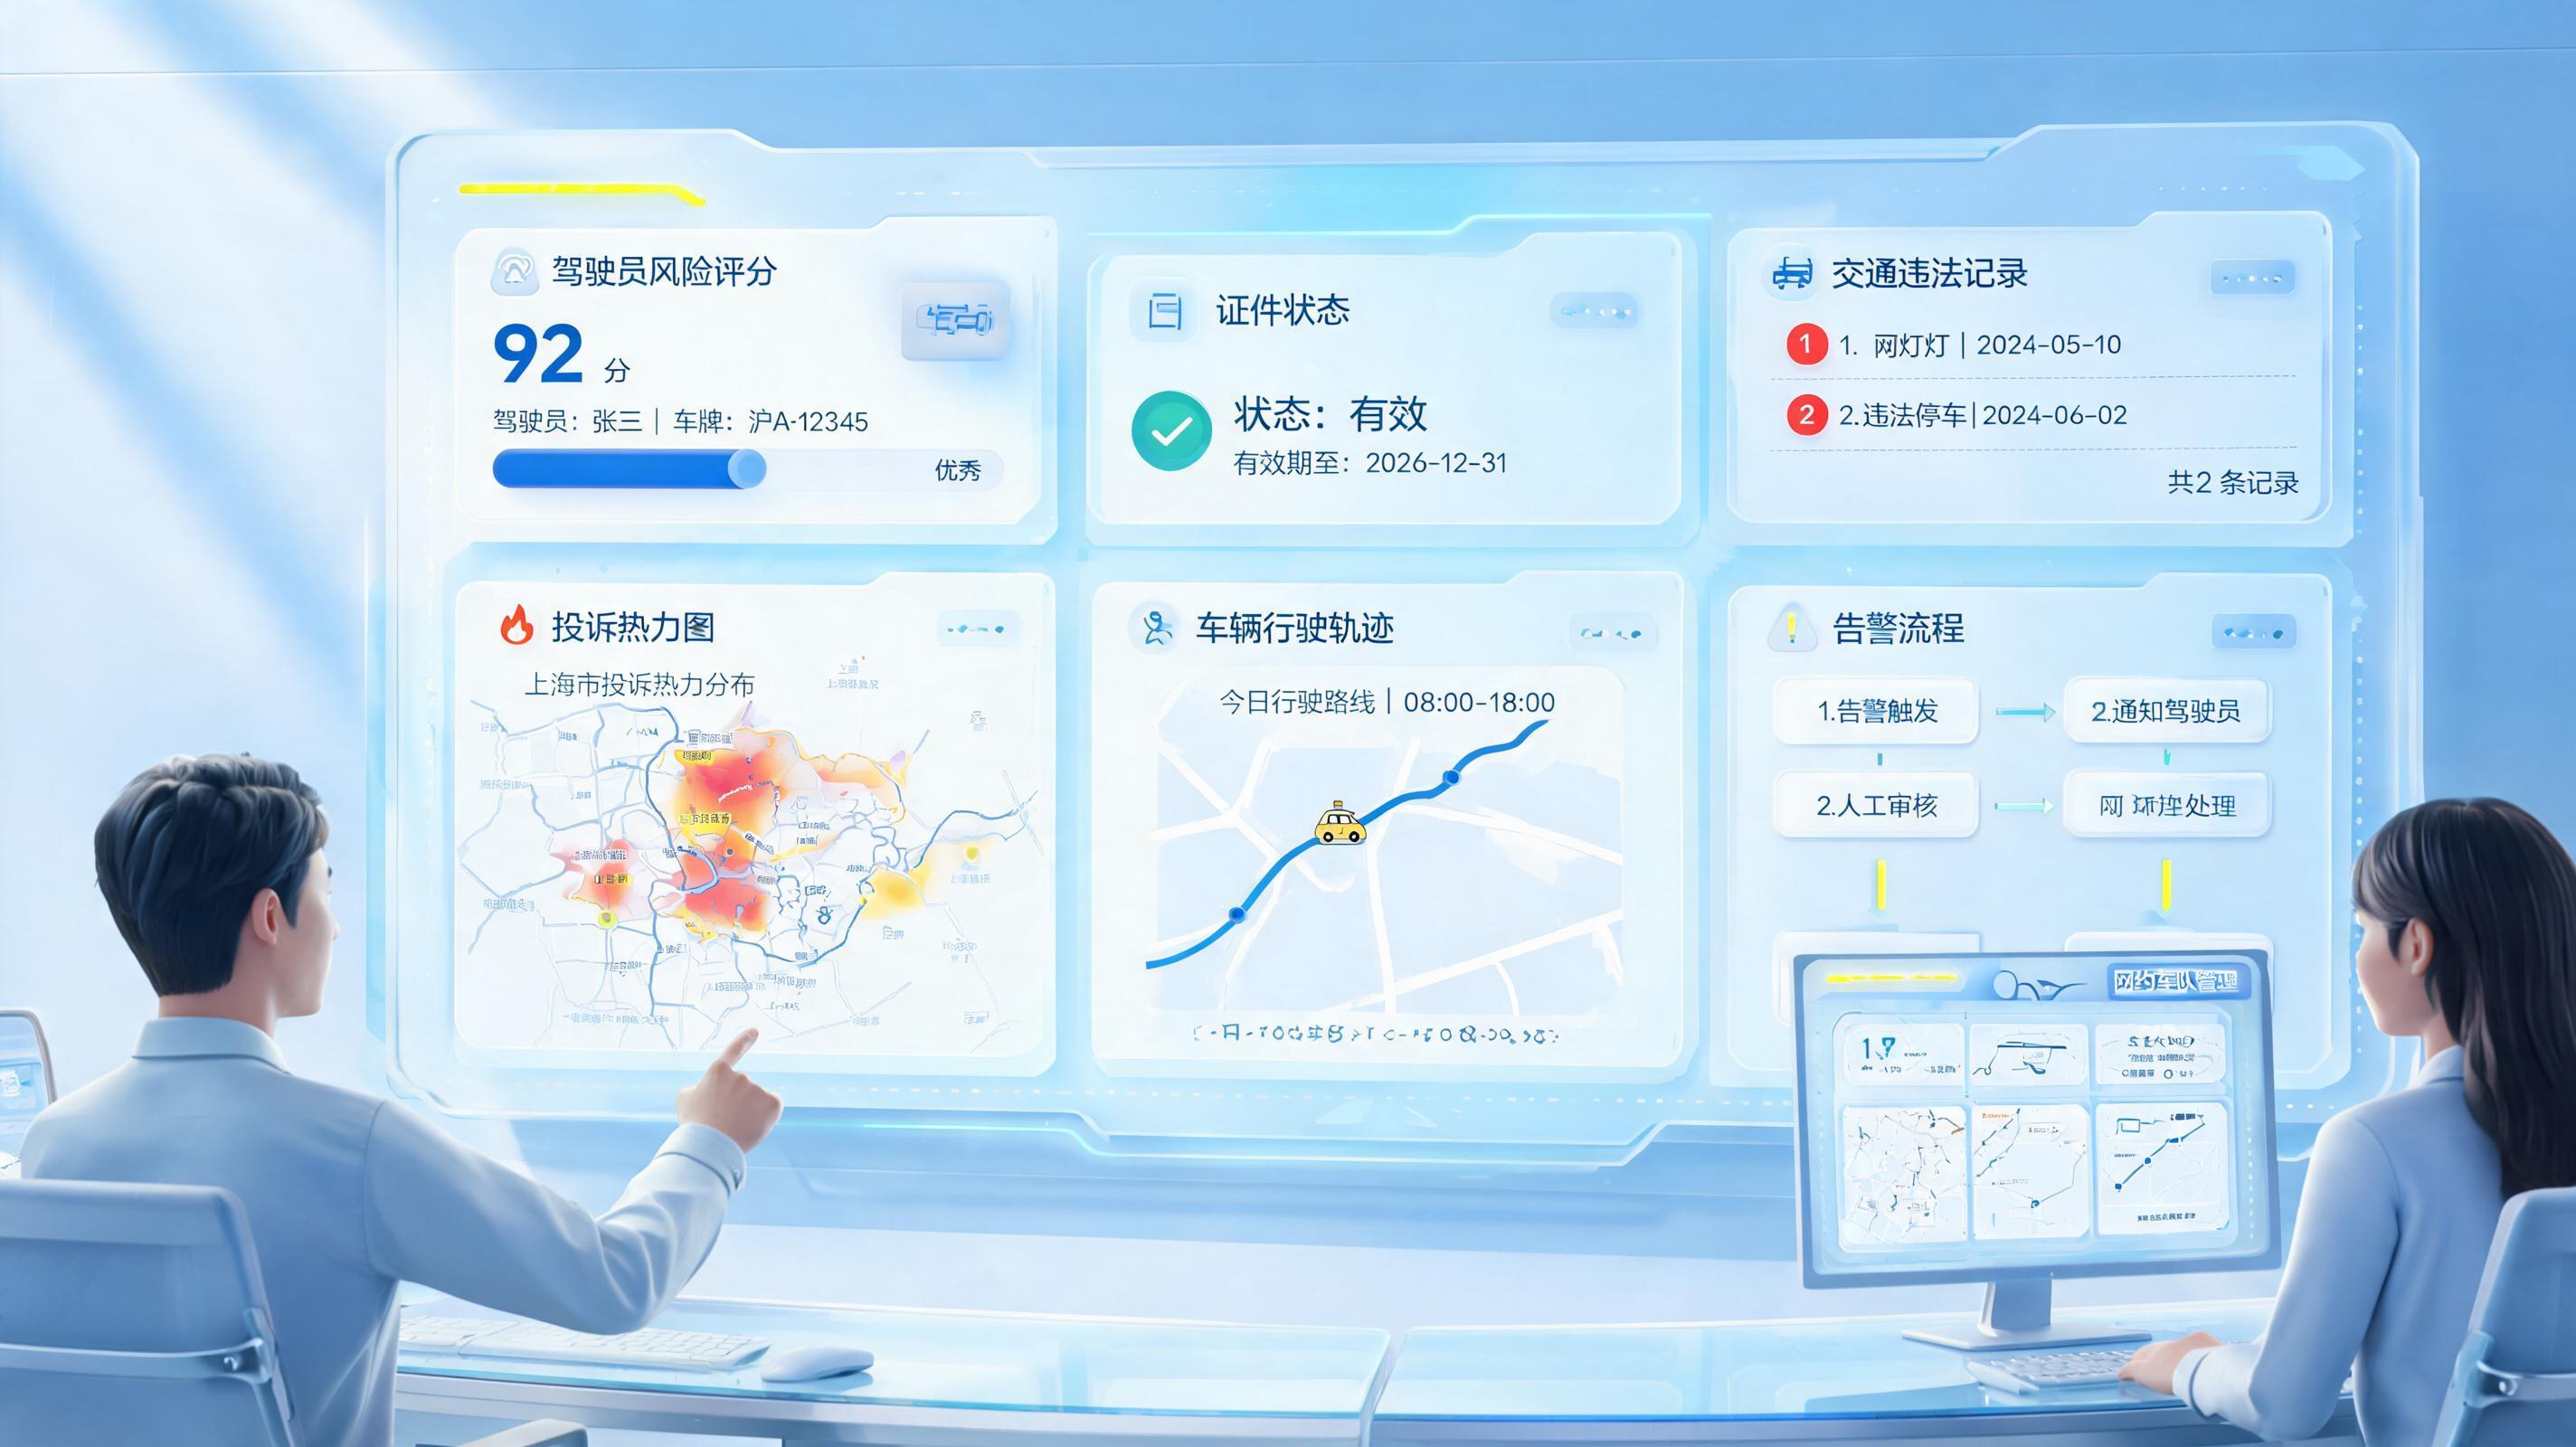
- 流程办理场景:某省级通信运营商利用“意图识别 + RPA 取证”智能体,自动解析客户投诉记录并调度云端机器人执行系统取证,年处理量可达上万份报告。
- 策略排班场景:某重型制造企业通过采集计划数据,结合场地、工时等多重规则约束进行校验,利用智能体即时生成生产车间的可视化排班策略。
总结
四个困惑不是孤立的:数据不干净,ROI 就算不准;ROI 算不清,组织就不敢投入;组织不协同,工程化就只能在一个个孤岛里重复造轮子。 一个务实的起手式是:同时选定一个边界清晰的任务和一个可采集的验收指标,借助具备“规划-执行-记忆-工具”能力的 Agent 架构,用最小数据集跑出可检查的结果,再用这个结果去争取组织调整和工程化投入的空间。