性能监控智能体是什么?系统性能场景的概念与边界界定
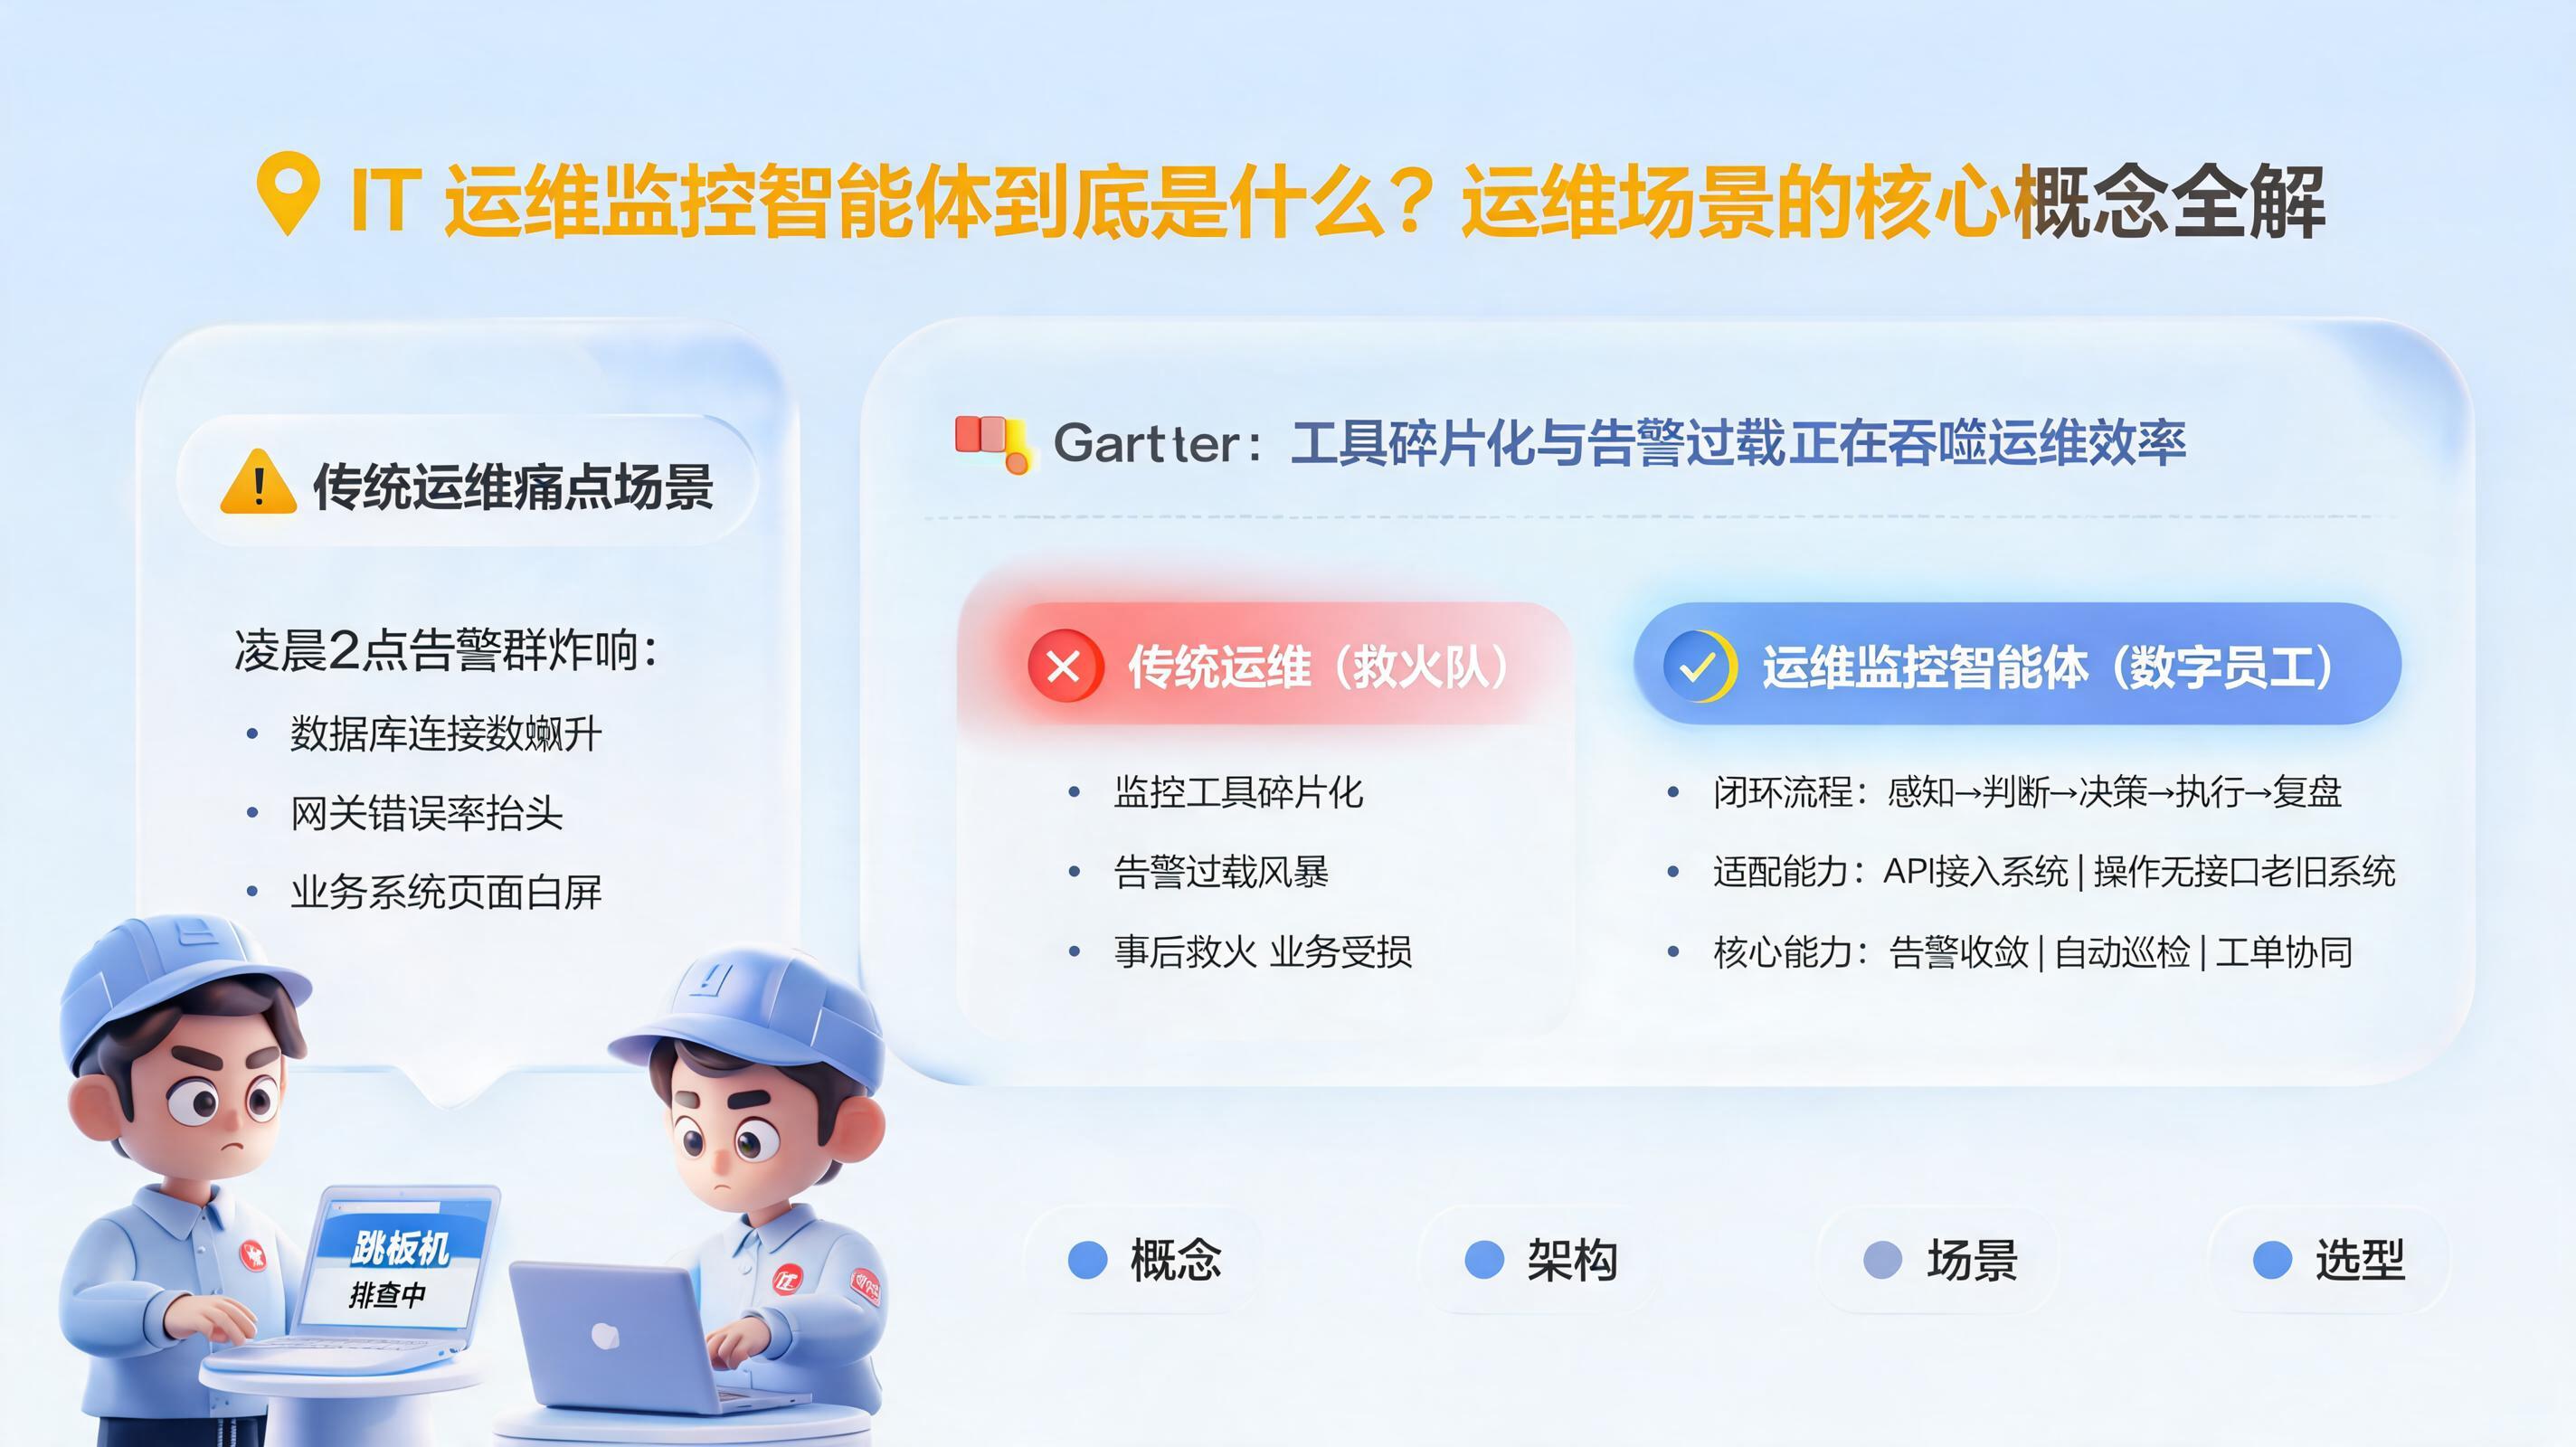
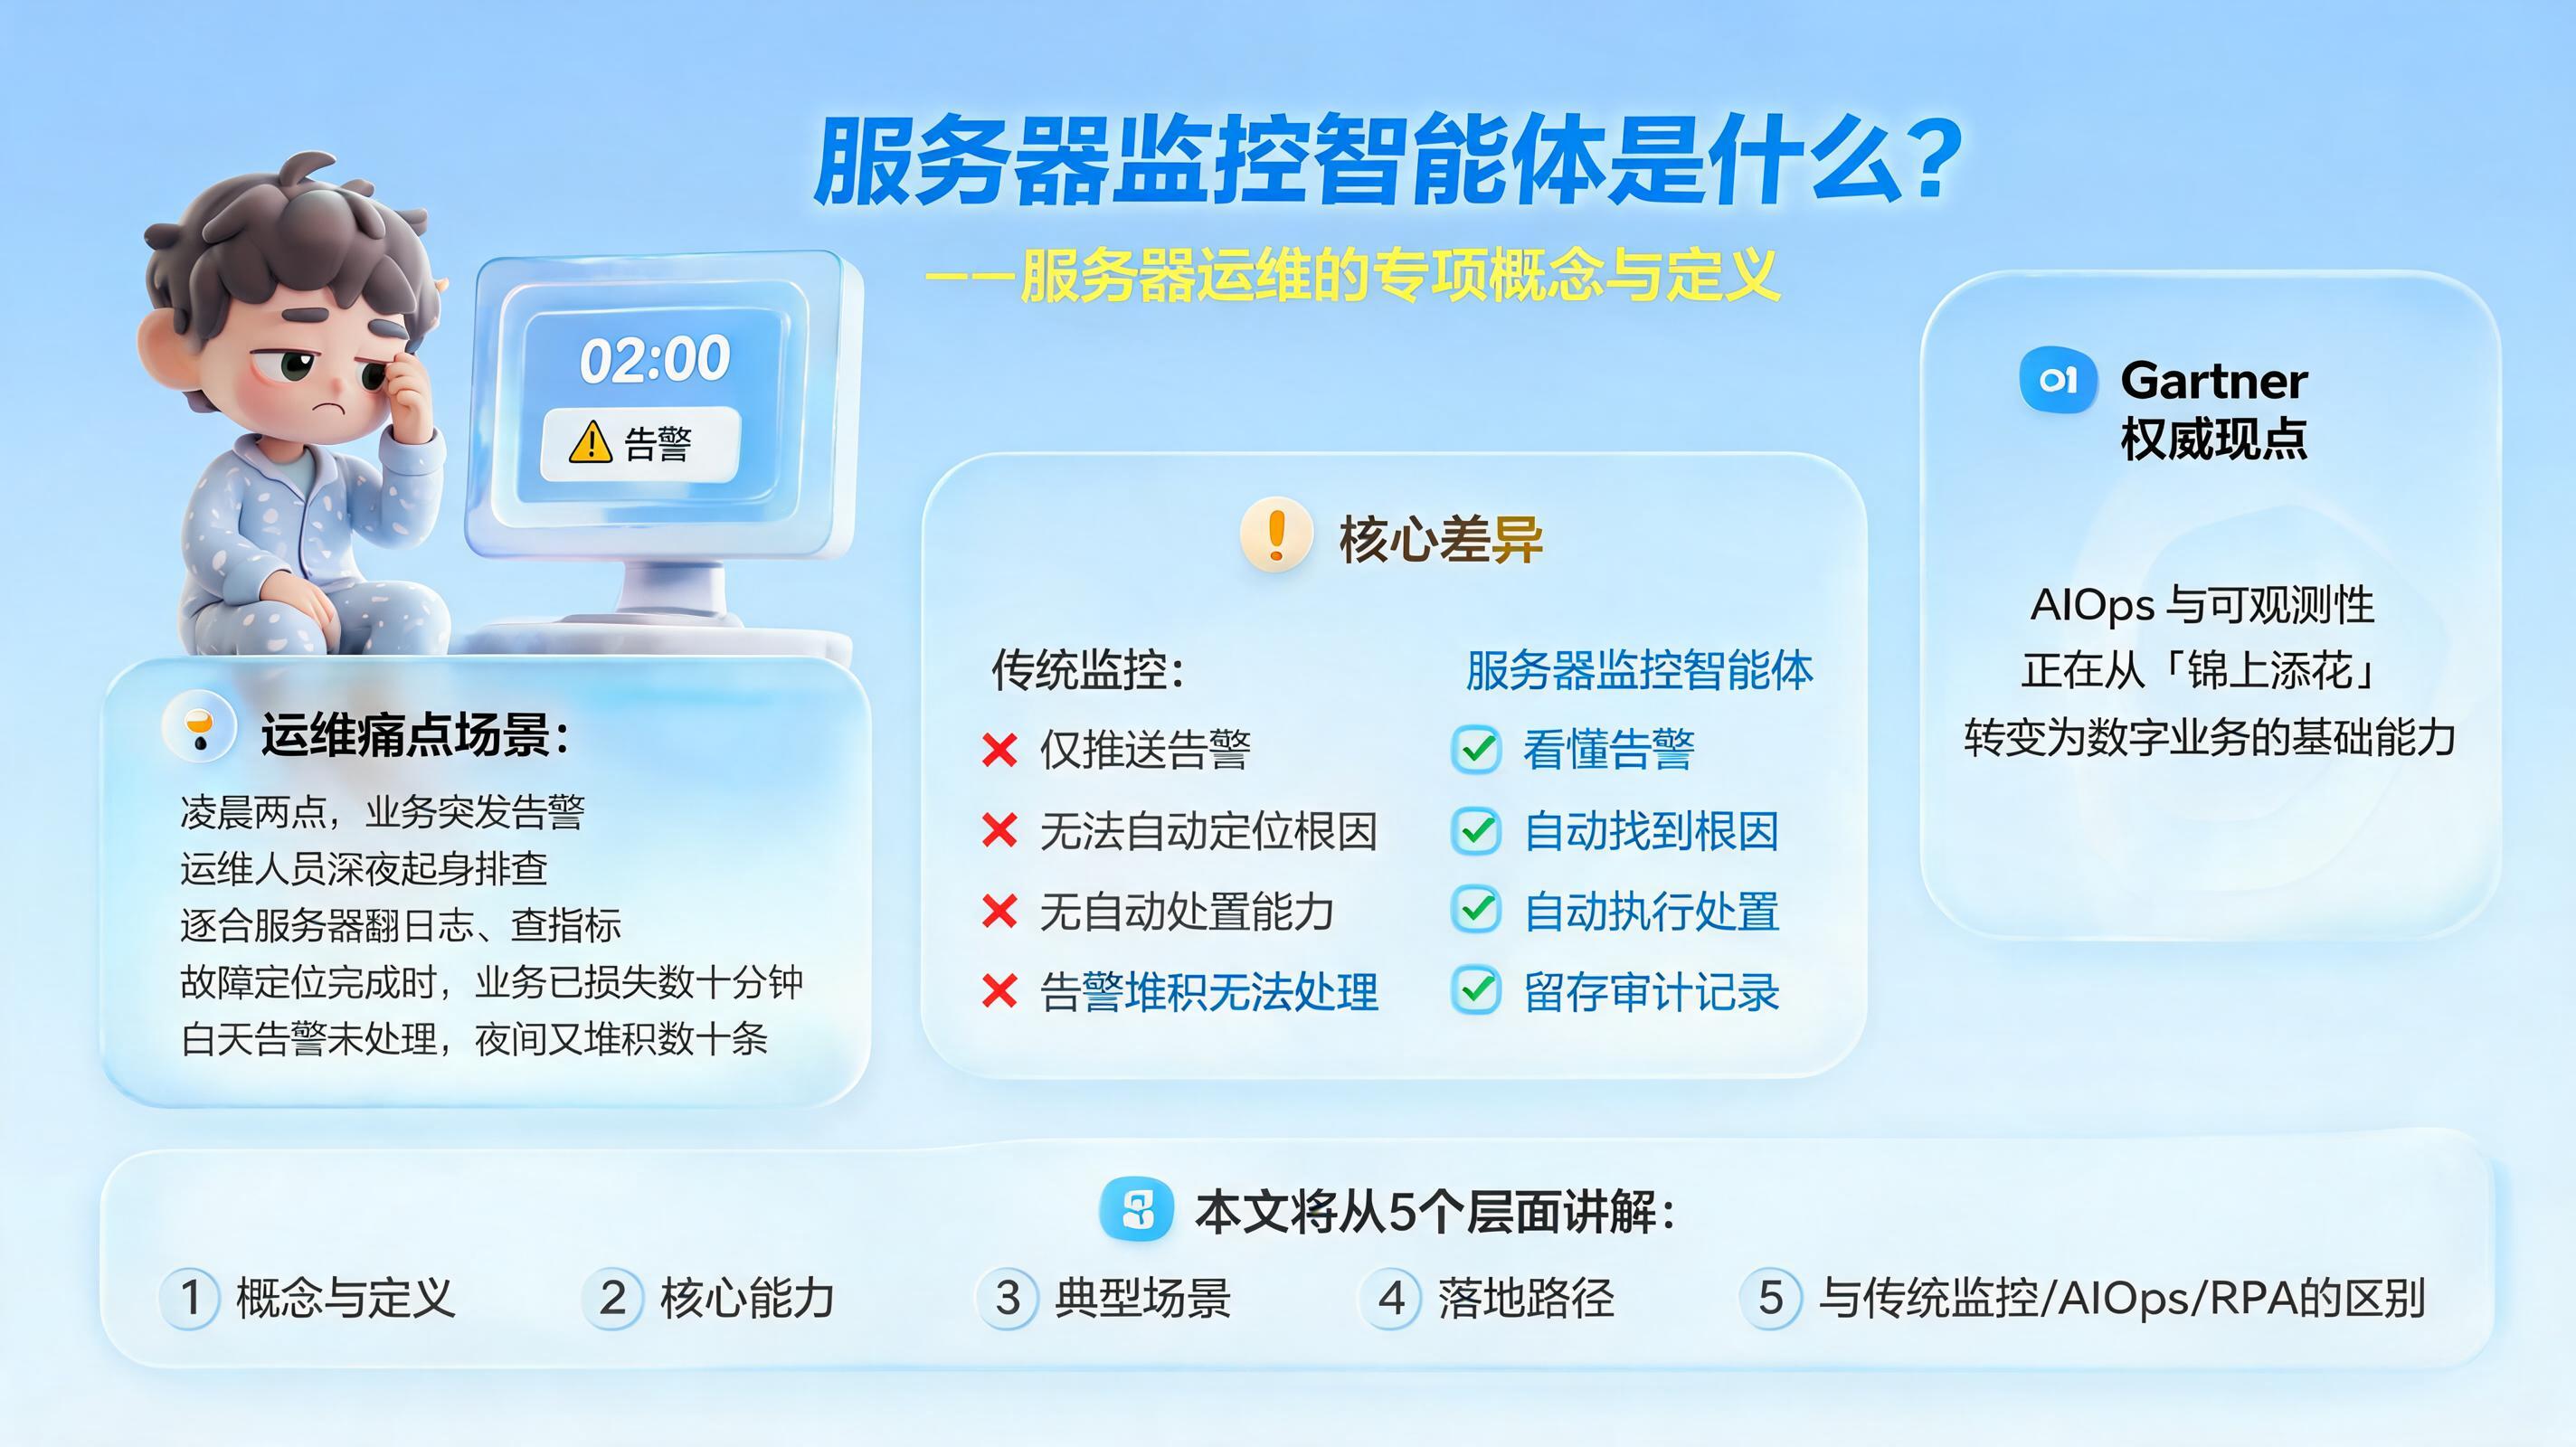
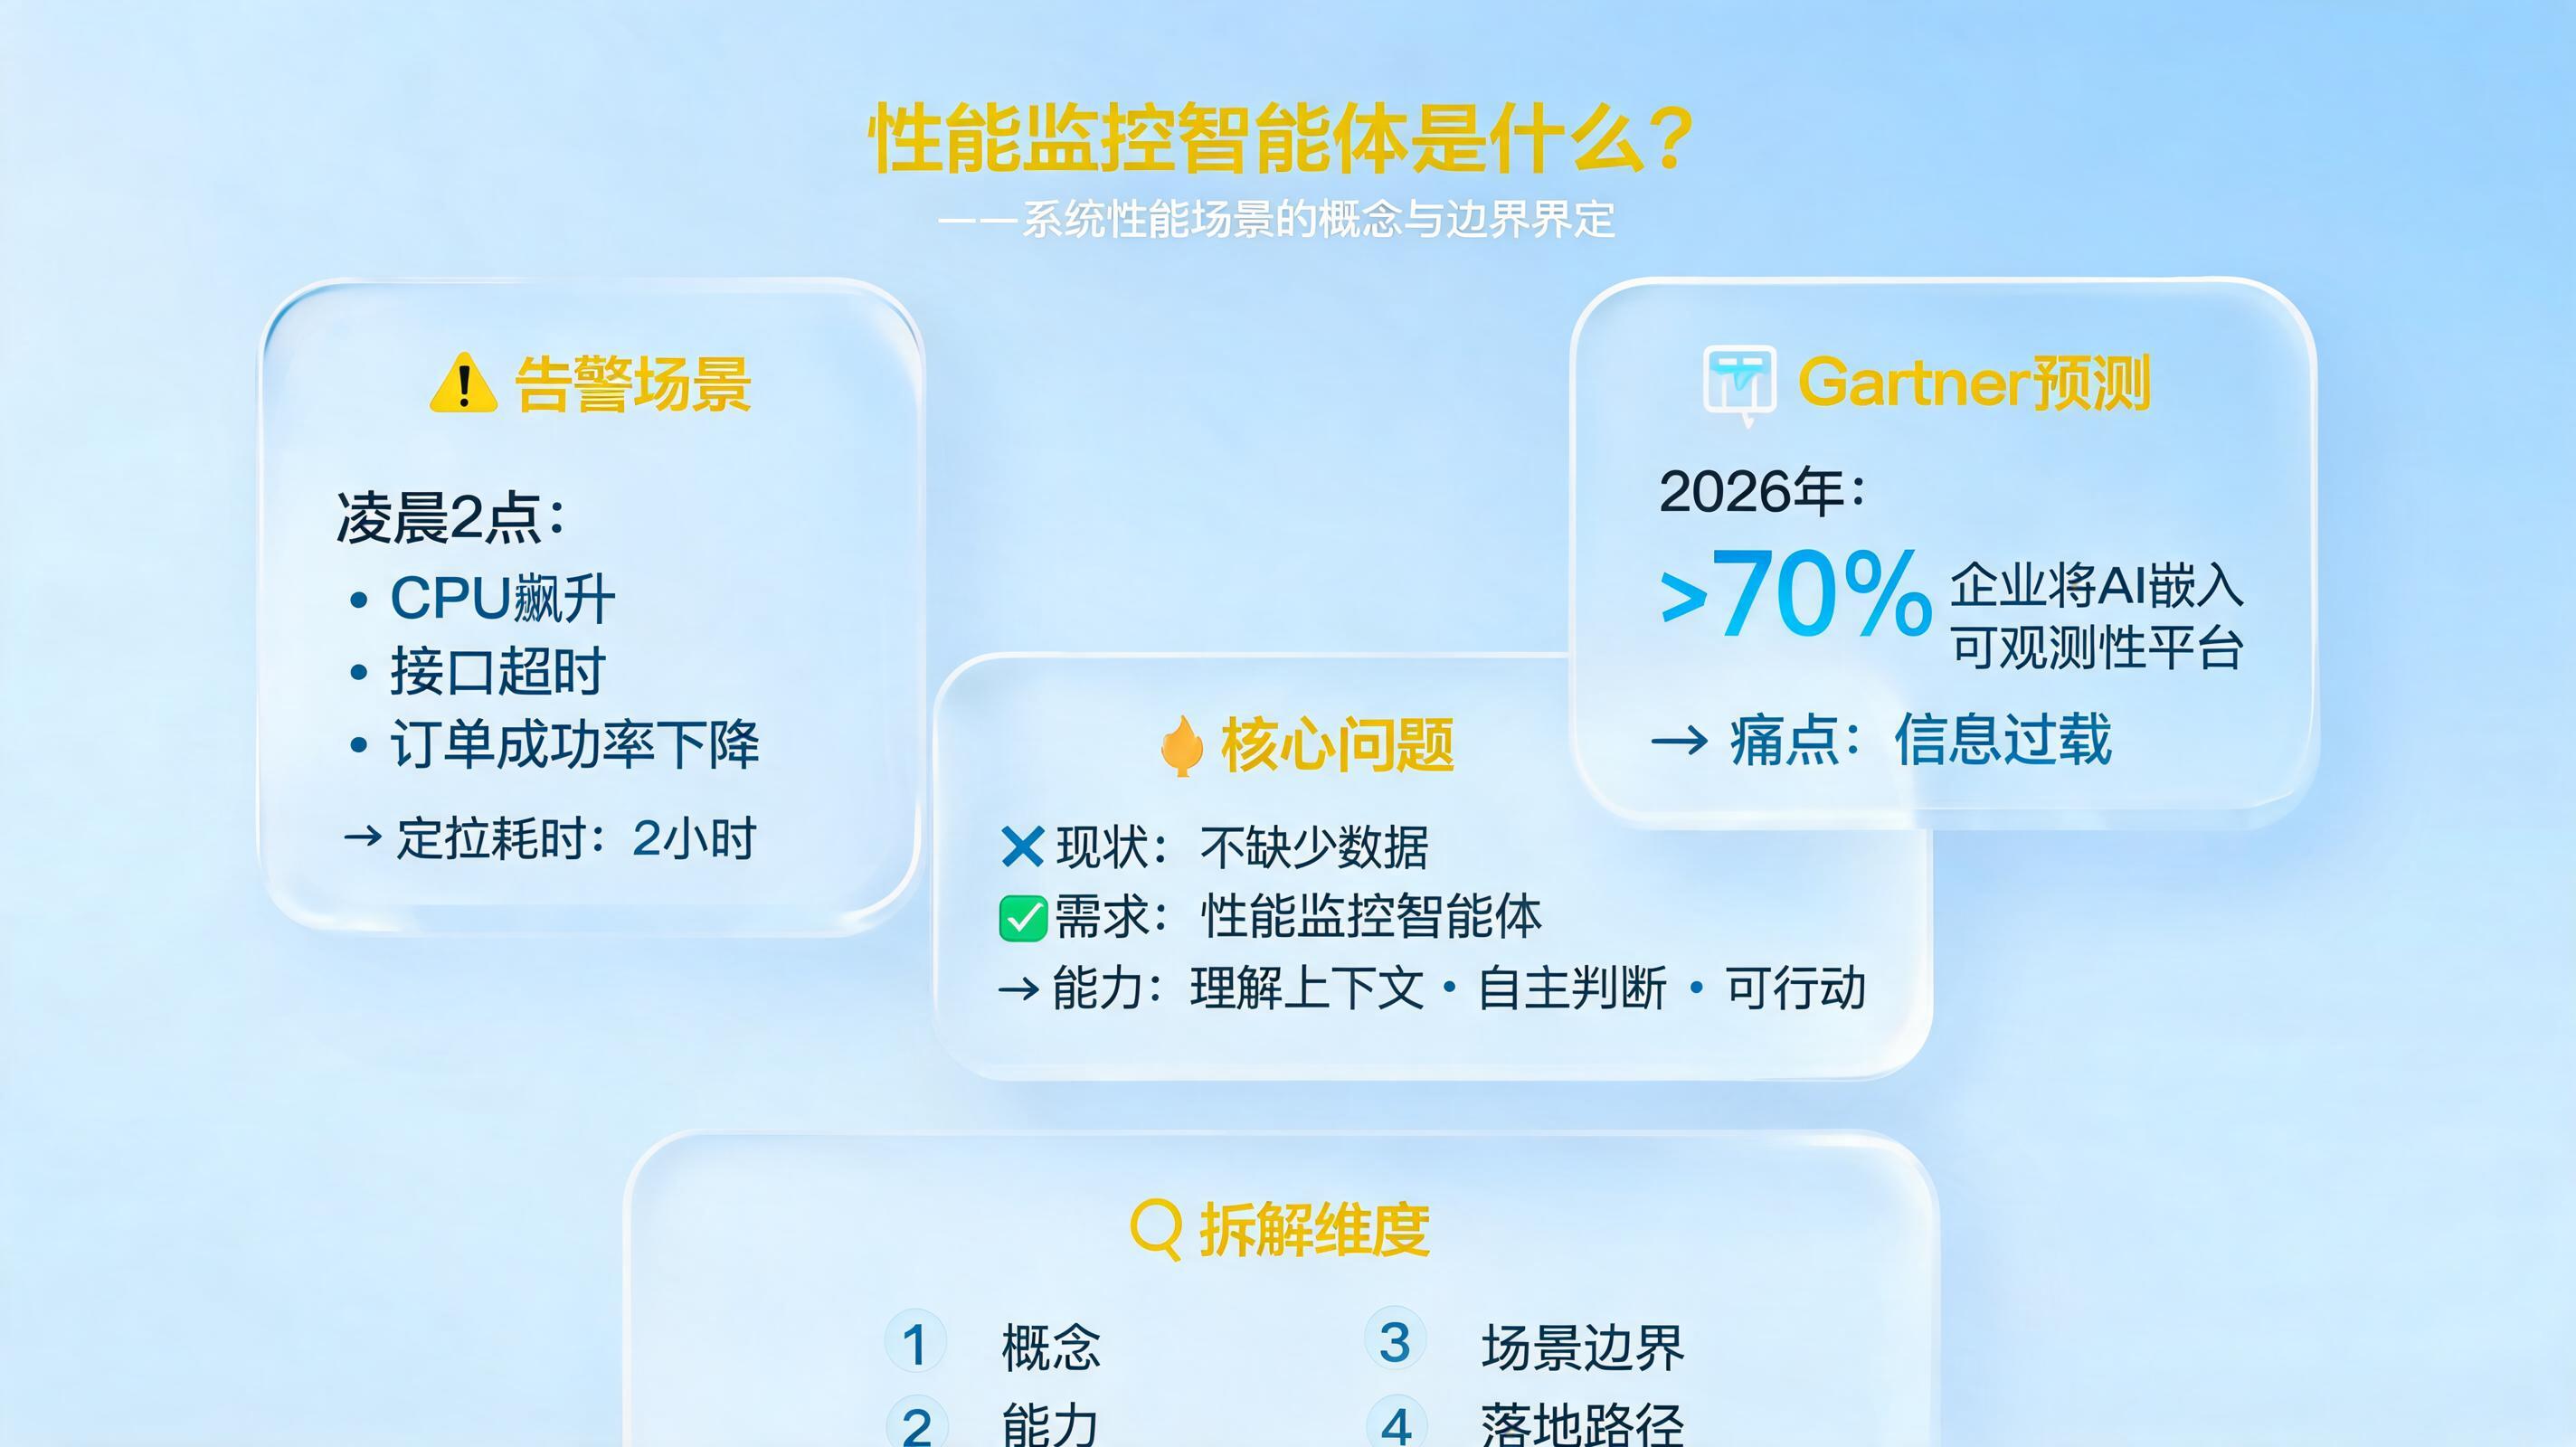
凌晨两点,告警群突然炸开:CPU飙升、接口超时、订单成功率下降。运维团队一边翻看仪表盘,一边在日志、链路、变更记录之间来回切换,真正定位问题却花了两个小时。Gartner曾提出,到2026年,超过70%的企业将把AI能力嵌入可观测性平台,但工具越多,信息过载反而越严重。问题不在于缺少数据,而在于缺少一个能理解上下文、做判断、能行动的“性能监控智能体”。这正是本文要回答的:性能监控智能体是什么?系统性能场景的概念与边界界定又该如何理解?我们将从概念、能力、场景边界和落地路径四个角度拆解。
一、为什么系统性能管理需要智能体?
1.1 传统性能监控的三大失灵
传统监控体系并不缺数据,缺的是从数据到决策的“最后一公里”。当系统规模扩大、微服务增多、云资源动态变化时,传统方式会暴露三个典型问题:
- 告警疲劳:阈值告警大量重复、关联性差,真正关键的告警容易被淹没。
- 数据孤岛:指标、日志、链路、事件、变更分散在不同平台,排障时需要人工来回切换。
- 响应滞后:发现问题靠人、定位问题靠人、处置问题还靠人,MTTR难以持续下降。
这些问题的本质,是监控工具只能“呈现状态”,不能“理解状态”,更不能“推动闭环”。
1.2 从“监控工具”到“智能体”:角色发生了什么变化
传统监控工具的角色是采集、展示和告警;性能监控智能体的角色则是感知、理解、推理、行动和学习。
通过实在Agent,企业可以把已有的监控告警、日志平台、CMDB、工单系统和自动化脚本串起来,让智能体按预设SOP执行巡检、降噪、派单、通知和恢复验证。它不替代底层监控,而是成为监控体系之上的“判断与行动层”。
二、性能监控智能体到底是什么?
2.1 一句话定义
性能监控智能体,是面向系统性能场景的AI Agent。它以SLO和用户体验为中心,持续消费指标、日志、链路、事件、拓扑和变更数据,进行异常检测、根因分析、影响评估、告警降噪,并在授权范围内执行处置动作的软件实体。
它不是一个更大的仪表盘,也不是一个只会聊天的运维机器人,而是一个能围绕“系统是否健康、哪里不健康、为什么、怎么办”形成闭环的数字员工。
2.2 五个核心能力
- 感知:接入多源可观测性数据,包括Metrics、Logs、Traces、Events、拓扑和变更记录。
- 理解:结合业务拓扑、依赖关系、发布变更和历史基线,理解异常发生的上下文。
- 推理:做关联分析、根因候选排序、影响面评估,并给出置信度。
- 行动:通知、创建工单、执行低风险脚本、触发扩容、验证恢复结果。
- 学习:从人工反馈和处置结果中优化基线、规则和SOP。
2.3 与传统 APM、监控告警的五个区别
- 目标不同:传统监控关注指标是否越界,智能体关注业务SLO是否达成。
- 交互不同:传统方式是人找数据,智能体是主动推结论。
- 范围不同:传统告警常看单点,智能体看全链路和影响面。
- 处置不同:传统方式靠人工救火,智能体推动人机协同闭环。
- 知识不同:传统规则依赖静态阈值,智能体结合动态基线和专家知识。
2.4 实在Agent在性能监控中的位置
实在Agent可以作为智能体编排与执行层,连接监控平台、日志系统、CMDB、工单和自动化工具。它让性能监控从“看见异常”走向“处理异常”。
例如,某农牧集团在统建系统数据监控场景中,用智能体自动监控关键数据异常,减少人工巡检和漏报。某电商团队在直播与经营指标监控场景中,通过7×24小时无缝巡检,将“人肉盯盘”升级为秒级预警,人工巡检工作量削减约90%,违规处置响应效率提升约5倍。这些经验同样可以迁移到系统性能监控:自动巡检、实时对比、异常告警、闭环跟踪。
三、系统性能场景的概念:监控什么、为谁监控?
3.1 概念定义
系统性能场景,是为保障业务系统在可用性、时延、吞吐、错误率、资源效率和成本等方面达成目标,对基础设施、应用服务、中间件、数据库、网络、终端和云资源进行持续观测、分析、决策和处置的活动集合。
它既包含技术视角,也包含业务视角。技术视角看CPU、内存、GC、SQL、网络丢包;业务视角看订单成功率、支付时延、页面加载速度、API可用率。
3.2 四个层次
- 基础设施层:主机、容器、网络、存储、云资源。适合自动巡检、容量预测、异常检测。
- 应用服务层:JVM、线程池、连接池、缓存、消息队列、数据库。适合根因推荐和慢调用分析。
- 业务体验层:订单、支付、登录、搜索、报表等业务链路。适合业务SLO监控和影响面分析。
- 运营效率层:告警量、工单量、MTTR、资源成本。适合降噪、自动处置和成本优化。
3.3 关键数据源
性能监控智能体要发挥作用,通常需要接入以下数据:
- 指标:CPU、内存、磁盘、网络、应用性能指标。
- 日志:错误日志、访问日志、审计日志。
- 链路:调用链、服务依赖、耗时分布。
- 事件:发布、扩缩容、配置变更、故障事件。
- 拓扑:服务、主机、数据库、中间件之间的关系。
- 变更:代码发布、配置修改、数据库变更、网络策略调整。
3.4 以 SLO 为中心
性能监控智能体的核心不是“把CPU盯住”,而是把技术指标映射到业务SLO。比如,CPU升高本身不是问题,导致下单成功率下降才是问题。智能体需要回答:这个异常影响了哪些业务?影响多大?是否需要立即处置?
四、边界界定:哪些该交给智能体,哪些不该?
4.1 技术边界:增强而非替代
性能监控智能体不应替代APM、NPM、日志平台和自动化运维引擎。它的价值在于消费这些平台的数据,做关联、判断和编排。没有底层采集,智能体就没有“眼睛”;没有自动化执行工具,智能体就没有“手”。
4.2 数据边界:没有数据就没有智能
智能体的诊断能力高度依赖数据质量。如果指标缺失、日志不规范、链路不完整、变更记录不可查,根因推荐就会失真。企业落地时,应先保证关键系统的可观测性基础,再逐步扩展智能体能力。
4.3 决策与安全边界:高风险操作必须有人把关
- 低风险操作:通知、工单、告警摘要、自动巡检、清理临时文件、非核心服务重启,可交给智能体自动执行。
- 中风险操作:扩容、限流、降级、切换只读,需审批或双人复核。
- 高风险操作:核心数据库DDL、交易链路开关、资金相关变更,不应全自动执行。
在合规审计场景中,实在Agent的合规审计闭环能力可提供操作全程留痕、自动触发时效监控,满足审计与监管要求。性能监控智能体同样需要权限控制、审批流和操作日志,确保“能行动”但不“乱行动”。
4.4 组织边界:人机协同的 RACI
智能体适合做“第一响应者”,人做“最终决策者”。开发、SRE、运维和业务部门需要共同定义SLO、SOP、权限和升级路径。只有组织边界清晰,智能体才不会成为新的“告警黑洞”。
五、落地路径:从告警降噪到自动闭环
5.1 四步走
- 接入与观测:统一指标、日志、链路、事件和变更数据。
- 降噪与关联:合并重复告警,识别同一根因,过滤无效噪音。某电商竞品监控智能体曾通过规则与模型过滤约九成无效噪音,这一思路同样适用于告警治理。
- 根因与建议:给出根因候选、影响面、置信度和处置建议。
- 处置与验证:低风险自动执行,高风险审批执行,完成后自动验证并生成复盘。
5.2 典型场景与成效
- 7×24自动巡检:替代人工定时检查,降低漏报和迟报。
- 告警降噪与根因推荐:减少MTTR,提升排障效率。
- 容量预测与弹性扩缩:在保障SLO的同时优化资源成本。
- 变更风险监控:发布后自动比对关键指标,异常时快速回滚或通知。
- 合规审计与留痕:满足监管要求,提升合规响应速度。
通过实在Agent,企业可以把这些场景编排成可复用、可审计、可学习的智能体流程,让性能监控从“救火”走向“预防”。
5.3 衡量指标
- MTTD:平均发现时间
- MTTR:平均恢复时间
- 告警准确率
- 自动化处置率
- SLO达标率
- 人工工作量削减比例
- 误报率与漏报率
六、常见误区与选型建议
6.1 三个常见误区
- 以为智能体等于全自动无人运维:高风险操作仍需人工决策。
- 以为接入大模型就能诊断:没有数据、拓扑和SOP,模型只能“猜”。
- 以为只监控CPU和内存就够:业务SLO和用户体验才是最终目标。
6.2 选型 checklist
- 是否支持多源数据接入与统一关联?
- 是否能编排SOP并连接现有工单、脚本和自动化平台?
- 是否具备权限控制、审批流和全程留痕?
- 是否支持低代码配置和场景模板?
- 是否能从反馈中持续优化?
- 是否在电商、农牧、安全等场景中有可验证实践?
实在Agent在电商运营监控、农牧统建系统数据监控、合规审计等场景中的实践说明,智能体落地要场景化、可编排、可审计,而不是追求“万能大模型”。
结语:先界定边界,再释放价值
性能监控智能体是什么?系统性能场景的概念与边界界定,最终可以归结为一句话:它不是在现有监控工具上再加一个聊天框,而是把感知、判断、行动和复盘串成闭环的“数字运维同事”。企业应从高频、低风险、高价值的巡检与告警降噪切入,逐步走向人机协同的自动闭环。先定义边界,再释放价值,才能让智能体真正成为系统稳定性的增益项。
常见问题解答
1. 性能监控智能体和传统APM有什么区别?
APM负责采集、存储和展示应用性能数据;性能监控智能体负责理解上下文、关联多源数据、推荐根因、编排处置,并推动闭环。两者是互补关系,不是替代关系。
2. 没有全链路追踪数据,能落地吗?
可以。可以从指标、日志和事件开始,先做自动巡检、告警降噪和工单闭环。随着可观测性建设推进,再逐步接入链路和拓扑数据,提升根因定位准确率。
3. 会不会误操作生产系统?
关键在权限和边界设计。低风险操作可自动执行,中高风险操作必须审批或双人复核,并全程留痕。智能体的价值是减少重复劳动,而不是绕过安全控制。
4. 中小企业有必要上性能监控智能体吗?
如果企业告警多、运维人力少、SLO压力大,就值得从轻量场景开始。例如每日自动巡检、告警摘要、工单自动创建。投入不大,但能快速看到效率提升。
5. 如何衡量性能监控智能体的 ROI?
可以看MTTR下降幅度、告警准确率提升、人工巡检工作量削减、SLO达标率变化、故障损失减少和资源成本优化。建议先选一个高频场景做试点,用数据验证价值后再扩展。
实在Agent$$$性能监控智能体是什么?系统性能场景的概念与边界界定