GPT-5.6三个模型的区别:Sol、Terra、Luna怎么选?
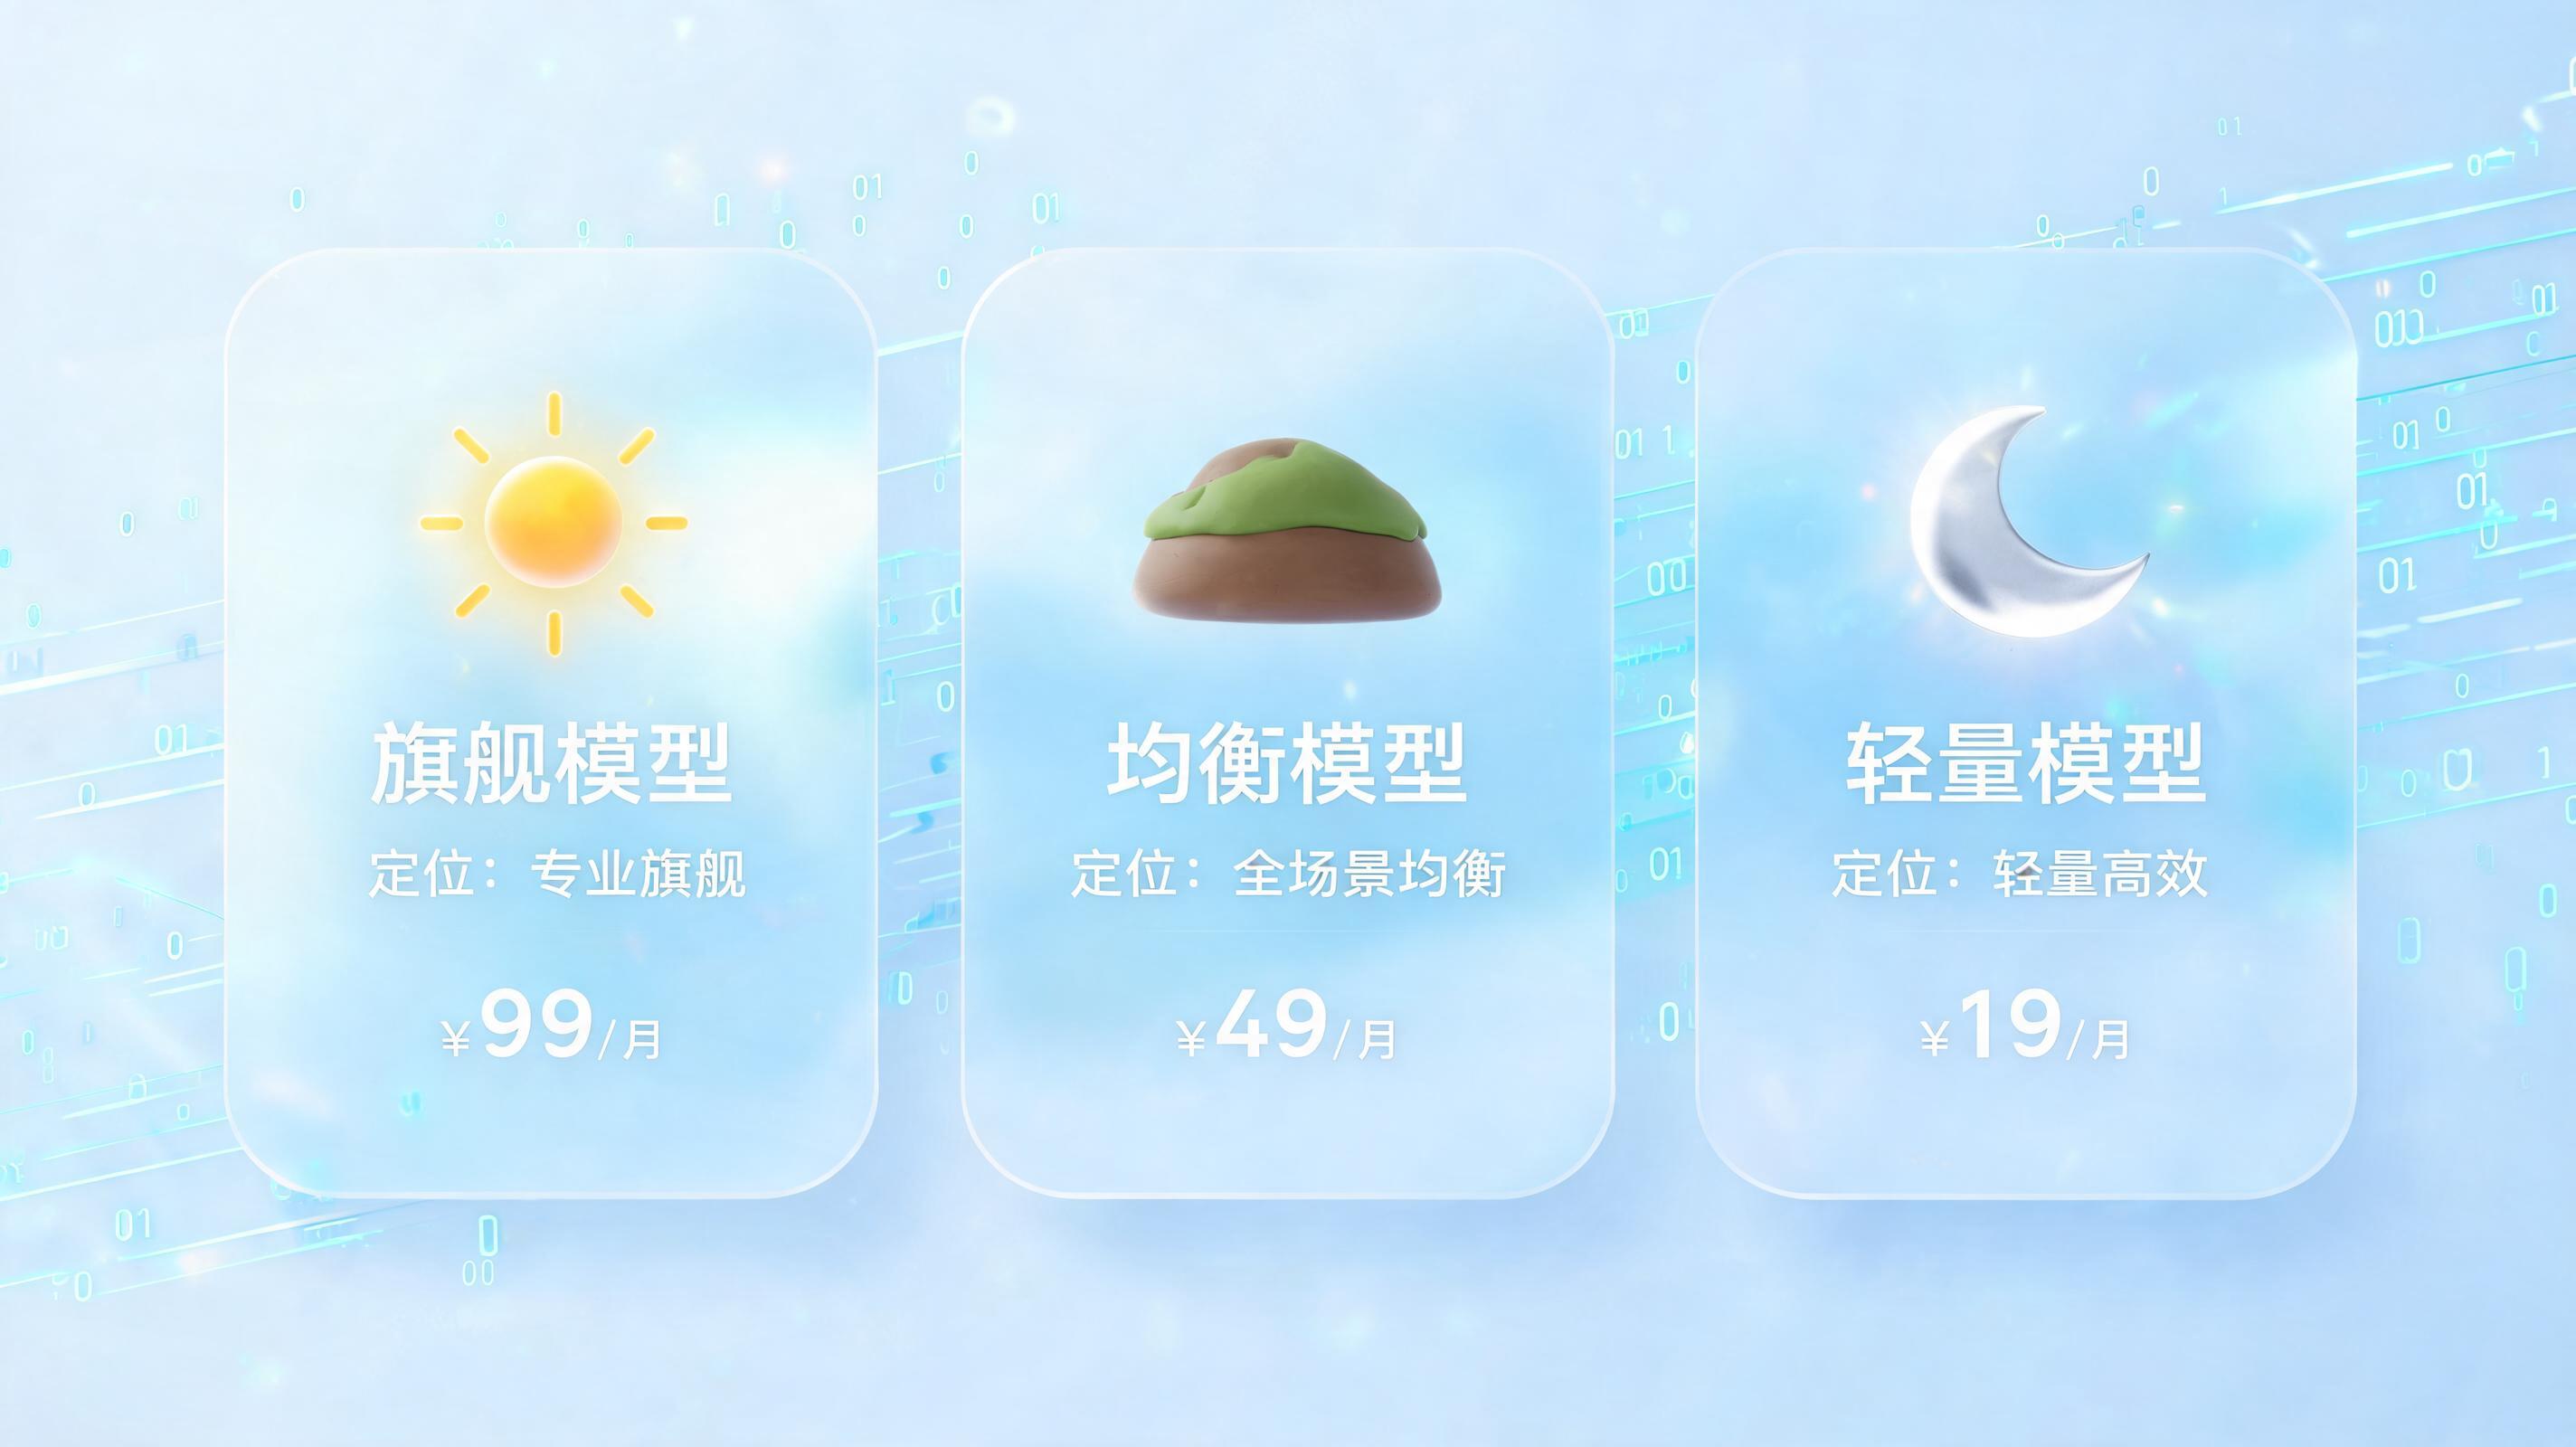
GPT-5.6 是 OpenAI 于 2026 年 7 月 9 日全面开放的新一代大模型系列,首次采用天体命名一次性发布三款模型:旗舰版 Sol(太阳)、均衡版 Terra(大地)、轻量版 Luna(月亮) 。三者共享 105 万 Token 上下文窗口和 12.8 万 Token 最大输出长度,训练数据截止 2026 年 2 月 16 日,输入支持文本和图片,输出仅支持文本。它们的核心区别在于定价、推理能力和适用场景——Sol 主攻复杂推理和编程,Terra 是日常生产的均衡之选,Luna 主打高并发和低延迟批处理。
一、核心定位与定价对比
三款模型不是“缩水版”关系,而是面向不同任务类型的独立产品线。定价差异直接反映了能力分层(价格已于 2026 年 7 月 30 日进行过调整,Luna 降价 80%,Terra 降价 20%,Sol 维持原价):
| 模型 | 定位 | 输入价格(/百万 Token) | 输出价格(/百万 Token) |
|---|---|---|---|
| Sol(太阳) | 旗舰,能力天花板 | $5 | $30 |
| Terra(大地) | 均衡,性能接近旗舰 | $2 | $12 |
| Luna(月亮) | 轻量,高并发低延迟 | $0.20 | $1.20 |
Sol 的费率与上一代 GPT-5.5 相同,Terra 和 Luna 在经过降价后价格更具竞争力。
二、推理强度:Sol 独有的六档调节
GPT-5.6 Sol 支持六档推理强度设置:none、low、medium、high、xhigh、max。推理强度越高,模型投入的计算量越大,输出质量通常更高,但延迟和 Token 消耗也随之增加。这意味着同一个 Sol 可以根据任务复杂度动态调整“思考深度”——简单任务用低档位快速响应,复杂任务切到 xhigh 或 max 换取更强的推理表现。
Terra 和 Luna 也支持推理强度调节,但档位选项少于 Sol。
三、性能基准:三款模型各有千秋
在长周期专业工作流评估 Agents‘ Last Exam(涵盖 55 个领域)中,Sol 创下 53.6 分的新高,领先 Claude Fable 5(自适应推理)13.1 分。即便在中等推理强度下,它也以约四分之一的预估成本领先 Fable 5 达 11.4 分。
在终端环境编程基准 Terminal-Bench 2.1 中,Sol 在 ultra 模式下跑出 91.9% 的得分,拿下所有已公开模型的最高分;标准模式下为 88.8%,超过 Claude Mythos 5 的 88.0%。
Terra 和 Luna 的表现同样不容小觑。OpenAI 官方数据显示,两者均超越了 Claude Fable 5,而成本仅为后者的约十六分之一。在 Artificial Analysis 智能指数中,Terra(max)和 Luna(max)分别得分 55 和 51,任务成本比 Sol 分别低约 50% 和 80%。
四、如何选择:按场景匹配
| 你的场景 | 推荐模型 | 理由 |
|---|---|---|
| 复杂推理、跨文件编程、前沿研究 | Sol | 能力天花板,值得为准确率支付更高单价 |
| 日常办公、代码解释、资料整理、文档修改 | Terra | 性能接近旗舰,价格仅为一半 |
| 批量分类、表格提取、简单重复的规则化任务 | Luna | 速度最快、成本最低,适合高并发场景 |
一个实用的习惯是:解释代码、整理资料先选 Terra;跨很多文件、需要反复检查时切换到 Sol;批量分类、提取表格字段则交给 Luna。
总结
GPT-5.6 三款模型的区别可以概括为一张表:
| 维度 | Sol | Terra | Luna |
|---|---|---|---|
| 定位 | 旗舰,能力天花板 | 均衡,日常主力 | 轻量,高并发批量 |
| 输入价格 | $5/百万 Token | $2/百万 Token | $0.20/百万 Token |
| 输出价格 | $30/百万 Token | $12/百万 Token | $1.20/百万 Token |
| 推理强度 | 六档可调 | 支持调节 | 支持调节 |
| 核心场景 | 复杂推理、长链路 Agent | 日常办公、常规开发 | 批量处理、低延迟响应 |
OpenAI 用三档产品的组合拳,试图在能力和成本两个维度同时覆盖市场需求。选型的核心逻辑是:按任务难度和成本敏感度匹配,而非一味追求最强模型。