大模型审单有幻觉怎么办?大小模型融合审核方案
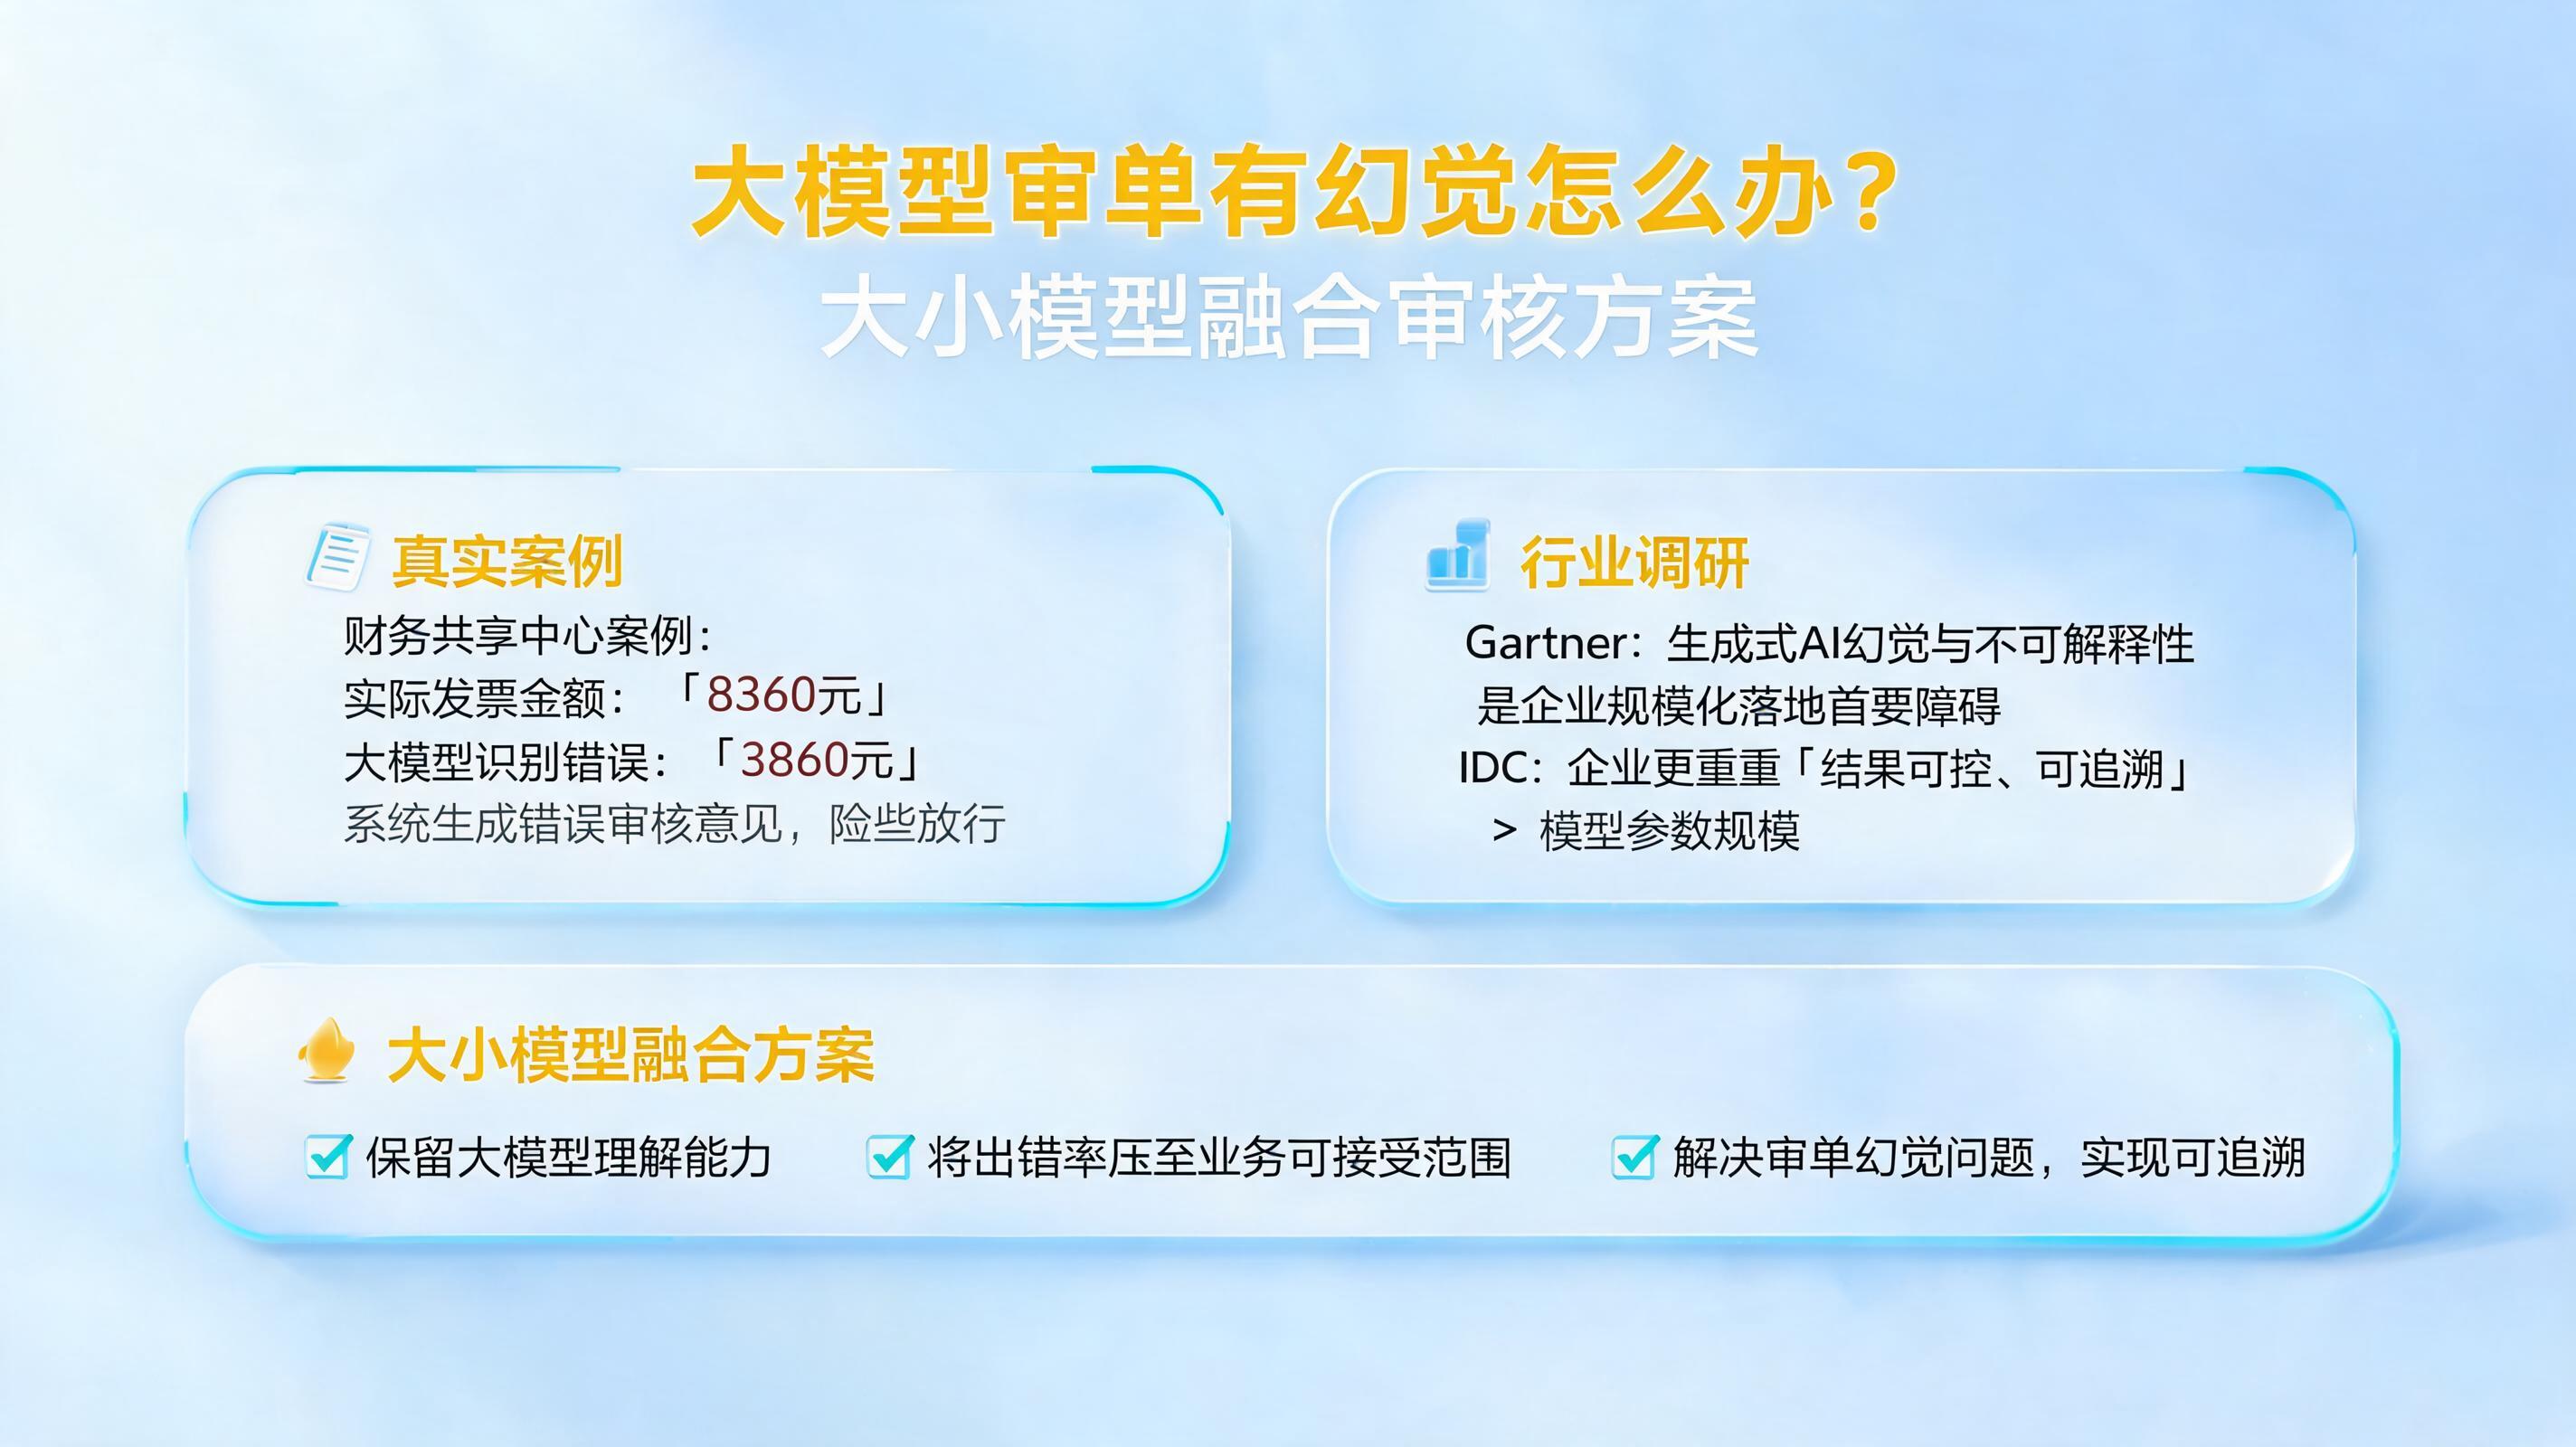
一位财务共享中心的负责人讲过这样一件事:月底结账高峰期,系统自动审核通过了一批差旅报销单,其中一张的发票金额是 8,360 元,而系统抓取到的数字是 3,860 元——小数点没错,数字顺序也没错,就是第一个字符被"理解"成了另一个字符。更麻烦的是,系统还附上了一段看似合理的审核意见,语气笃定,让人差点直接放行。
这不是个例。Gartner 曾多次在报告中提示,生成式 AI 的"幻觉"与不可解释性,是企业规模化落地的首要障碍;IDC 的相关调研也显示,企业在评估智能审单类方案时,"结果可控、可追溯"的权重正在超过单纯的模型参数规模。大模型审单的幻觉到底从哪来?有没有一种既保留大模型理解能力、又能把出错率压到业务可接受范围的工程方案?这正是"大模型审单有幻觉怎么办?大小模型融合审核方案"要回答的问题。
一、大模型审单的幻觉,究竟从哪里来?
很多人把幻觉理解成"模型不够聪明",于是第一反应是换更大的模型、加更长的提示词。但在审单这类场景里,幻觉的成因往往和模型规模无关。
1.1 三类高频幻觉场景
- 字段级误读:日期、金额、税率、发票号码等结构化字段被"合理猜测"。大模型擅长语义理解,却天生不擅长逐字符精确比对,尤其是模糊扫描件、骑缝章遮挡、手写体场景。
- 规则级臆断:面对"差旅住宿标准按职级分档,超标部分需附审批说明"这类条款,模型可能自行推导出一个并不存在的档位或阈值。
- 结论级过度自信:即使证据不足,模型也会输出完整、通顺、带有结论性的审核意见,让人误以为它"看懂了"。
1.2 为什么"换更大的模型"解决不了问题
大模型的输出本质是概率生成。参数再多,也只是让"最可能的答案"更接近常识,而不是让"唯一的正确答案"被确定性执行。审核业务的诉求恰恰相反:同一张单据、同一套制度,今天和明天的结论必须完全一致。用概率工具去承担确定性职责,等于把风险埋进了流程里。
这也是为什么越来越多企业转向"大小模型融合"的思路——通过实在Agent 这类支持多模型协同的智能体平台,把任务拆开:该理解的理解,该判定的判定,各司其职。
二、大小模型融合审核:让大模型负责理解,让小模型负责判定
核心逻辑并不复杂:大模型做它擅长的事,小模型做它可靠的事,交叉验证兜住风险。
2.1 双轨制分工逻辑
- 大模型(LLM/VL):泛化理解能力强,适合处理制度文本解析、非标单据识别、异常原因归类等"没有固定模板"的任务,但可能产生幻觉。
- 小模型(NLP/OCR):处理稳定、几乎不产生幻觉,在固定字段抽取、印章识别、表格结构还原上表现可靠,但需要标注与训练成本。
- 融合方式:同一份单据由两条轨道并行处理,结果一致则直接放行;结果不一致则进入异常池,交由规则引擎复核或人工介入。
这种设计的价值在于:幻觉不再是一个"必须消灭"的问题,而是一个"必须被发现"的问题。 只要有独立信源做对照,单点幻觉就会被拦截在下游之前。
2.2 交叉验证:让结论可被证伪
实在Agent 在财务审核场景中的做法是,把抽取结果与审核结论分层校验:
- 抽取层:大模型抽取 / NLP 抽取 / 正则语义抽取 / 手写体抽取 / 表格格式抽取 / 印章抽取多路并行;
- 审核层:数值计算规则、时间匹配规则、文本逻辑规则、跨文档审核规则并行执行;
- 比对层:任一路径结果冲突即标记异常,附带冲突字段与置信度,推送给复核人员。
换句话说,系统不会告诉你"这张单子没问题",而是告诉你"这张单子的第 3 行金额有两个来源,取值不一致"。
2.3 制度条款转代码规则:从"概率生成"到"确定性执行"
真正把幻觉风险压到最低的一步,是制度驱动。企业上传财务制度文件后,由大模型解析条款语义,自动生成可执行的代码级审核规则;后续实际审单时,规则以代码方式运行,不再依赖大模型现场推理。
这就是常说的"零幻觉审核":大模型只参与一次性的规则生成,不参与每一次的单据判定。抽取结果注入代码规则后,即使不调用大模型,也能完成审核。制度变了,重新解析一次即可,规则库随之更新。
三、落地路径:六步人机协同审单闭环
方案能不能用,取决于它嵌进业务流程后是否顺畅。以一个完整的审单链路为例:
3.1 六个环节的完整链路
- 规则智能管理:上传制度文本,大模型解析生成可执行规则,人工确认后入库;
- 业务端提单:员工在原有系统提交单据,不改变操作习惯;
- 智能识别:OCR 小模型与大模型结合,完成字段与附件要素抽取;
- 深度校验:由 IDP 引擎执行规则校验,并对 ERP、发票查验、主数据等系统做穿透查询;
- 结论生成:输出 AI 审核辅助结论,标注通过项、异常项与依据条款;
- 人工确认与回填:复核人员处理异常单,确认结果自动回填业务系统,同时沉淀为学习素材。
3.2 人在什么位置介入最合适
好的自动化不是把人挤出去,而是把人放到风险最高的位置。实践中比较有效的分工是:
- 规则明确、字段清晰的单据,AI 直接放行;
- 规则命中但存在冲突的,AI 给出多个候选结论,人工一键选择;
- 制度未覆盖或语义模糊的,直接推人工,并把处理结果回流到规则库。
实在Agent 在这条链路上扮演的是"数字员工"角色:7×24 小时承接基础校验,同时通过标准 OpenAPI 与企业现有 ERP、费控、影像系统集成,不推翻既有 IT 架构。它还支持以 RPA 方式模拟人工登录审核系统,作为 AI 审核节点直接完成操作——这对那些短期无法开放接口的老系统尤其关键。
四、实战成效:一家区域财务共享中心的改造样本
某央企下属的区域财务共享分支机构,服务华南四省 188 家下属单位,年处理单据超过 25 万笔,业务类型多达 120 余种。改造前,它面临四个典型难题:
- 业务繁杂,标准化难度高;
- 单类业务配套十余项审核规则,判定链路长;
- 各省分子机构执行标准不统一;
- 人工审核负荷长期处于高位。
该中心最终采用"大模型+小模型"双轨制智能审单方案,覆盖 92 类核心业务场景。落地后的量化结果如下:
- 初审替代率达到 66%,数字员工 7×24 小时不间断作业,人工负荷降低超 60%;
- 审核准确率提升至 99.2%;
- 项目投入 10 个月即收回成本,ROI 提升 140% 以上;
- 打通系统数据孤岛后,风控响应速度提升 300%。
值得注意的是,这些收益并非来自"模型变得更聪明",而是来自分工更清晰:不确定的交给大模型理解,确定的交给规则和小模型执行,冲突的交给人和交叉验证处理。这套思路在制造业供应链单据核对、电商订单与发票匹配、IT 工单分类等场景同样适用。
五、如何评估一套大小模型融合审核方案是否靠谱
市面上的方案看起来都差不多,真正拉开差距的是细节设计。
5.1 四个必须问清楚的问题
- 规则是可解释还是黑盒? 优先选择能输出代码级规则、能看到"为什么通过/不通过"的方案。实在Agent 在制度解析后生成的是可读规则,而非一段隐式向量。
- 冲突怎么处理? 要确认多路抽取结果不一致时的判定优先级,以及异常池是否有完整的消息推送与复核入口。
- 有没有持续学习机制? 人工复核的每一次修改,都应被采集为学习素材,定期优化算法模型,形成闭环,而不是靠人工反复调提示词。
- 审计链是否完整? 审单是强合规场景,需要全链路日志、PDF 留痕、精细化权限(RBAC)管理,确保每一笔结论可追溯到依据。
5.2 两个常见选型误区
第一个误区是只看模型参数。参数规模决定的是能力上限,而审核业务关心的是错误下限。第二个误区是追求"全自动"。在制度尚未完全结构化的阶段,保留合理的人工确认环节,反而能加速规则库的积累与收敛。
结语
大模型审单的幻觉不是靠"换个更强的模型"就能消失的,它需要的是工程化的分工与兜底。大小模型融合审核方案的价值,正在于把大模型的泛化理解力与小模型的稳定确定性放在同一条流水线上:理解归理解,判定归判定,冲突有人管,结果可追溯。对企业而言,与其纠结模型会不会犯错,不如先建立一套能发现错误、拦截错误、并从错误中学习的机制。这才是智能审单从"能用"走向"敢用"的关键一步。
常见问题解答
Q1:大小模型融合之后,审核速度会不会变慢?
不会明显变慢。抽取层是并行执行的,小模型负责的固定字段抽取速度很快;真正耗时的是跨系统穿透查询,而这部分通常通过接口并发和缓存优化。实践中,多数场景的单据处理时间以秒计,且可以 7×24 小时不间断运行,整体吞吐远高于人工。
Q2:制度条款转成代码规则,准确率有保障吗?
大模型生成规则后,必须经过人工确认才能入库,这一步是质量闸门。由于规则以代码形式存在,一旦确认,后续每次执行结果完全一致,不会出现"同一条款两种判定"的情况。当制度更新时,重新解析并再次确认即可。
Q3:中小型企业没有 120 种业务类型,也适合这套方案吗?
适合。业务类型少意味着规则更容易收敛,落地周期更短。可以先从报销、发票查验、合同付款等 1—2 个高频场景切入,跑通"识别—校验—复核—回填"闭环后再逐步扩展,投入风险更低。
Q4:人工复核环节会不会变成新的瓶颈?
关键在于分流设计。如果规则覆盖充分,大部分单据会在系统内直接放行,人工只处理真正存在冲突或制度未覆盖的部分。案例中初审替代率达到 66%,意味着人工接触的单据量下降至原来的三分之一左右,复核人员反而可以聚焦于高风险、高价值的判断。
Q5:整套方案与企业现有 ERP、费控系统怎么衔接?
通常通过标准 OpenAPI 接口集成,不需要替换现有系统;对于短期无法开放接口的老系统,也可以用 RPA 方式模拟人工登录,作为 AI 审核节点接入。实在Agent 支持个性化配置与权限隔离,能够在不打破既有 IT 架构的前提下完成部署。