15万行追溯矩阵难维护?自动生成双向追溯方案
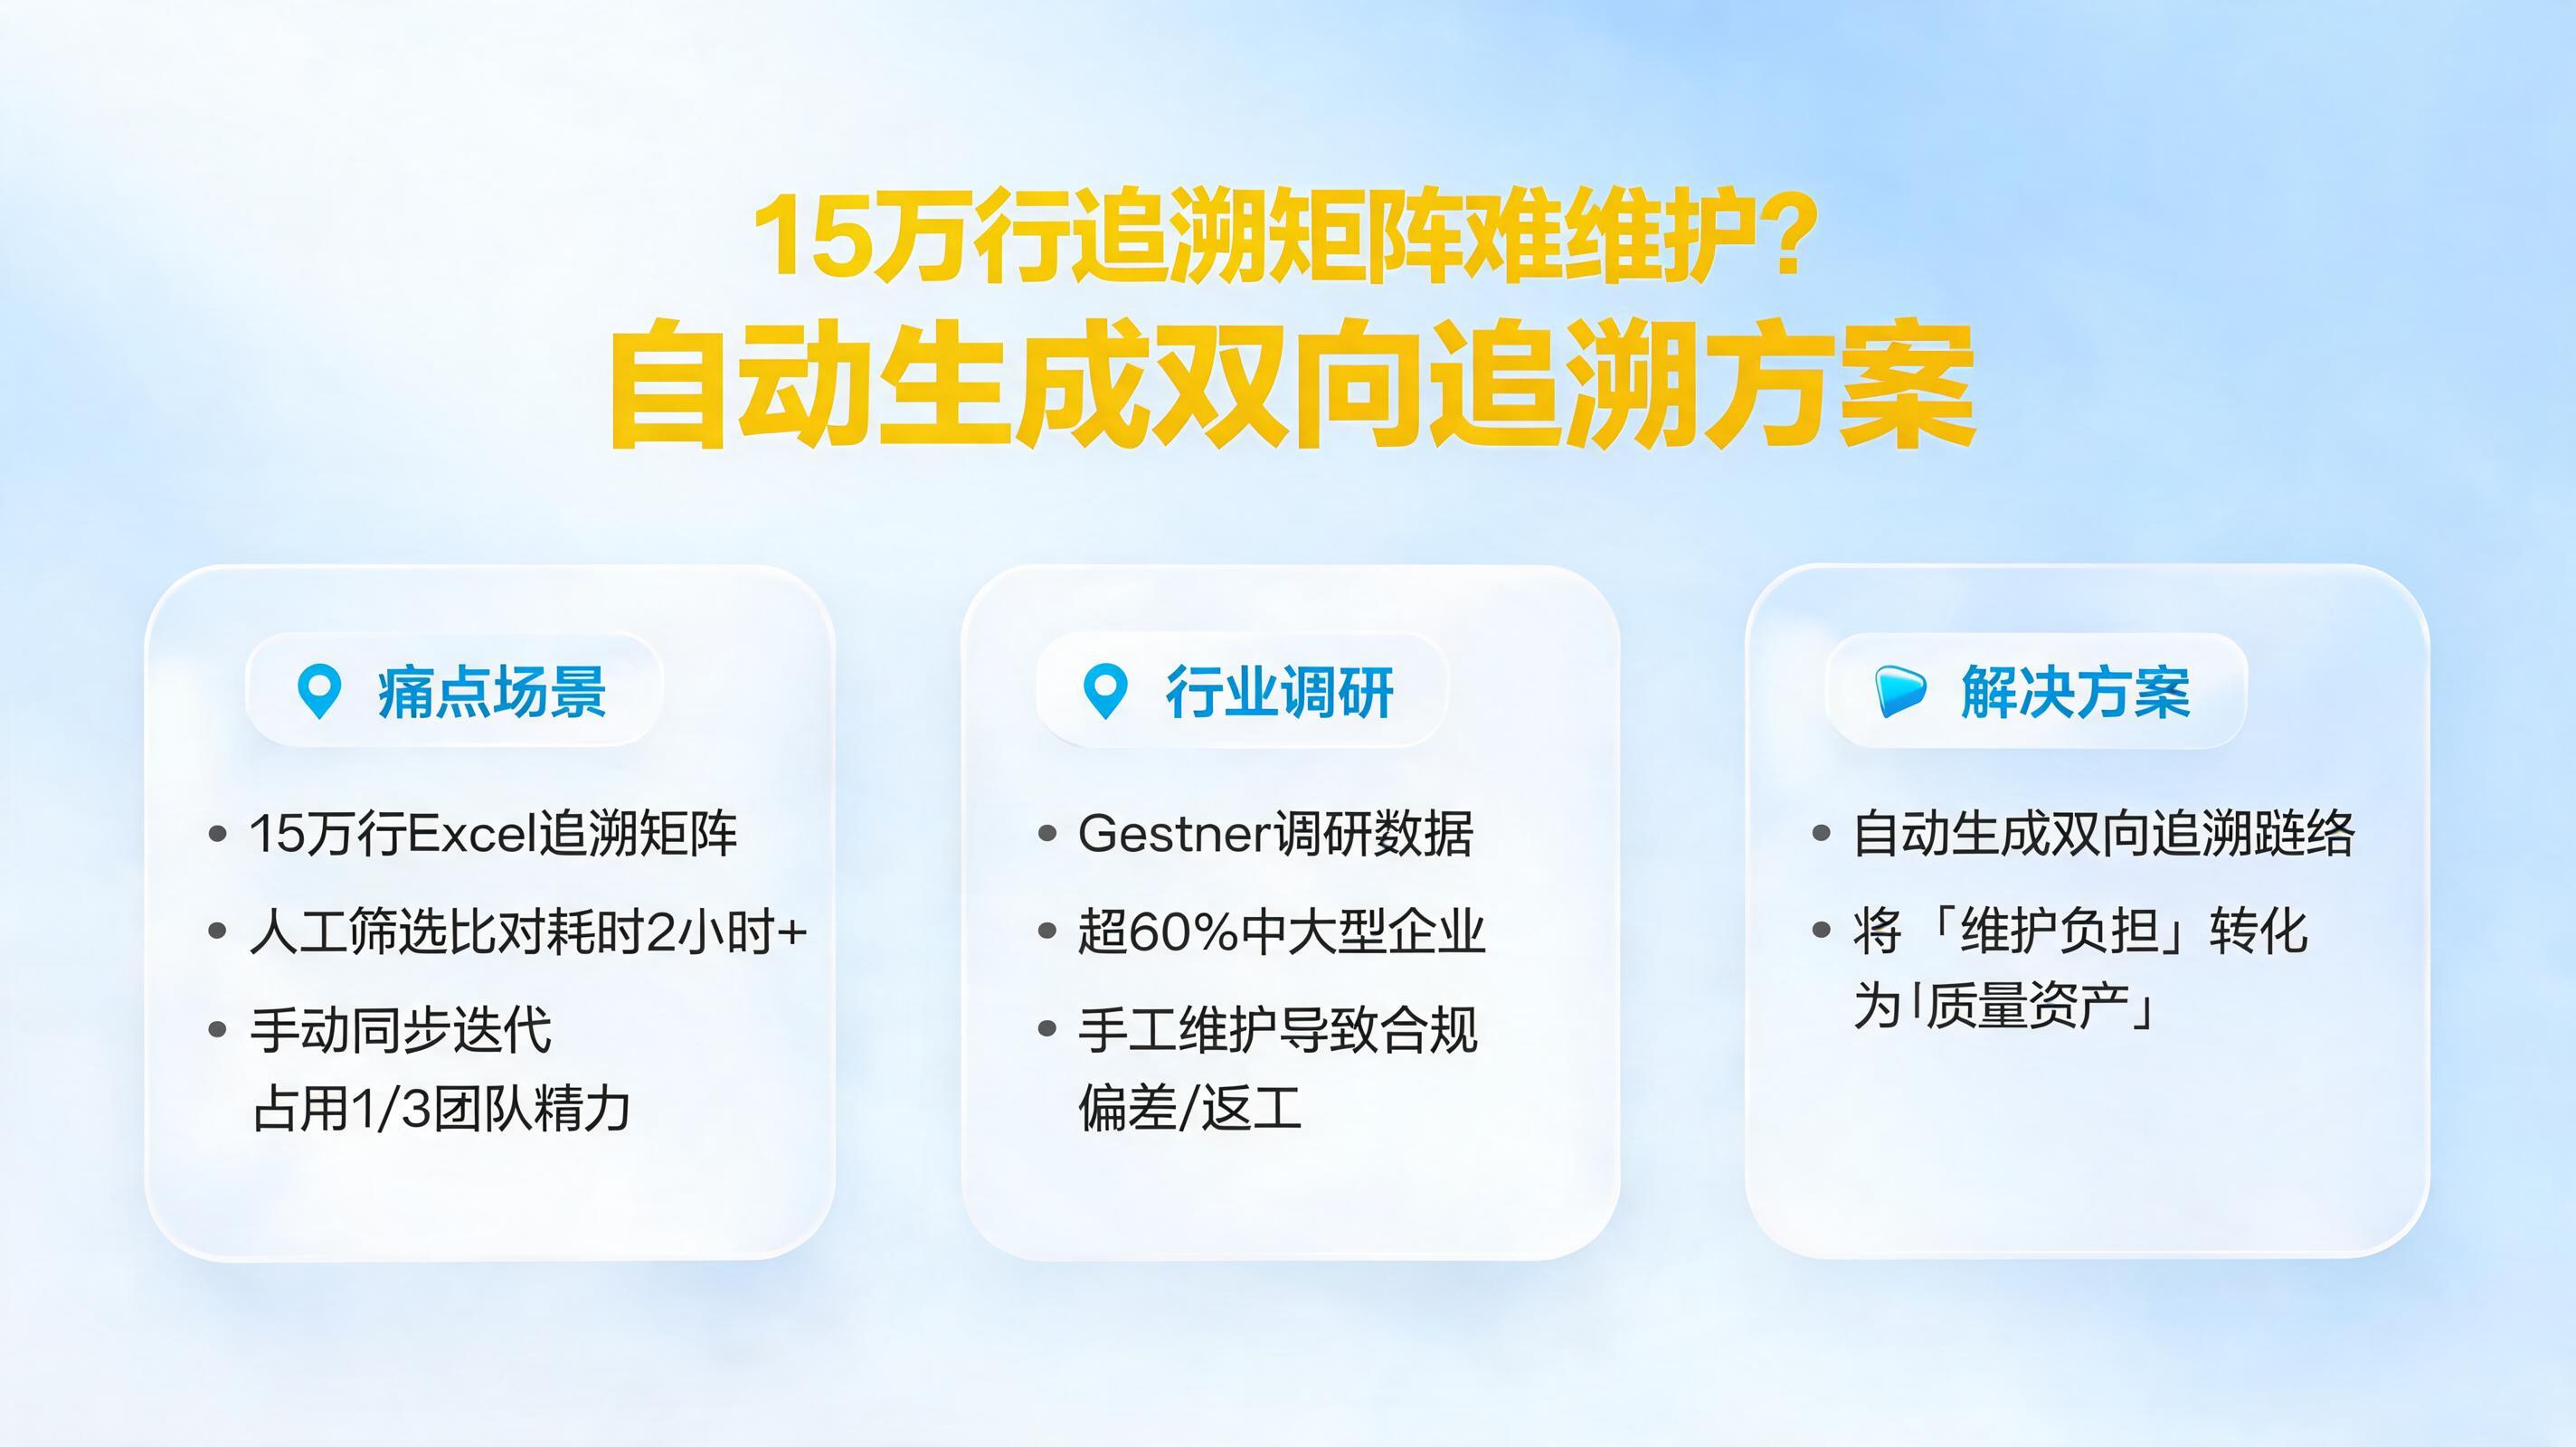
你有没有遇到过这样的场景:打开那份积累了多年的需求追溯矩阵,15万行数据铺满屏幕,每一个需求编号背后都牵着设计文档、测试用例、缺陷记录。想确认某个需求变更会影响哪些测试用例,需要人工在Excel里反复筛选、比对、跳转,花了两个小时才理清一条链路。更让人头疼的是,每次版本迭代后,这份矩阵就需要手动同步更新,维护成本几乎吞噬了团队三分之一的精力。
这并非个例。Gartner在一份关于企业级应用交付的调研中指出,超过60%的中大型企业在强监管行业中,因追溯矩阵维护不善导致过合规审计偏差或返工。需求追溯本应是质量保障的基石,但当它膨胀到数十万行的量级时,传统的手工维护模式已经走到了极限。本文将深入拆解追溯矩阵失控的根因,并给出一套可落地的自动生成双向追溯方案,帮助企业把“维护负担”转化为“质量资产”。
一、为什么15万行追溯矩阵会变成“不可维护的遗产”
1.1 追溯矩阵膨胀的根源:多标准叠加与工具孤岛
追溯矩阵的原始形态并不复杂,一张表格就能覆盖需求与测试的对应关系。但在实际企业环境中,它往往被多重因素推向失控。
- 合规标准交叉要求:以汽车电子行业为例,ISO 26262要求安全需求追溯到硬件指标和软件单元,而ASPICE又要求追溯到测试用例和变更记录。同一套系统需要同时满足多套标准的追溯维度,行数呈指数级增长。
- 工具链断裂:需求管理用一套系统,测试管理用另一套,缺陷跟踪又是第三套。数据无法自动流动,只能靠人工导出、合并、去重,每一次同步都是一次引入错误的可能。
- 组织壁垒导致的重复录入:业务部门、开发团队、测试团队各自维护一份“本地版本”的追溯表,格式不统一、粒度不一致,最终合并时才发现矛盾重重。
1.2 手工维护的代价:不只是时间
当追溯矩阵达到十万行级别,维护成本的构成已经远远超出“工时”本身。
- 一致性风险:人工在多个表格间复制粘贴,漏掉一条变更记录就可能造成审计时的链路断裂。
- 响应滞后:需求评审会上无法实时展示变更影响范围,决策依赖“会后再查”,拖慢迭代节奏。
- 知识流失:矩阵的维护逻辑往往只存在于个别资深成员的脑中,人员流动即意味着追溯能力断层。
在强监管行业,追溯矩阵的完整性直接等同于合规证据链的完整性。一旦断裂,影响的不仅是项目进度,更是审计通过率。
实在Agent在这一环节的价值在于:它不要求企业推翻现有工具链,而是通过智能体自动连接需求管理、测试管理、缺陷跟踪等系统,将多源数据按统一追溯模型进行归集与重组,从根源上消除人工搬运带来的不一致问题。
二、自动生成双向追溯方案的核心能力拆解
2.1 什么是“双向追溯”以及为什么它是关键
双向追溯意味着不仅能从需求正向查到测试用例,也能从失败的测试用例反向定位到受影响的全部需求。它的核心价值在于影响分析的完整性。
- 正向追溯:需求 → 设计 → 开发 → 测试 → 上线,确保每个需求都被验证覆盖。
- 反向追溯:缺陷/测试失败 → 定位关联需求 → 判断变更影响范围 → 触发回归策略。
- 双向闭环:变更发生时,系统自动标记所有受影响的上下游节点,而不是靠人工“顺藤摸瓜”。
传统工具大多只能做到单向的、静态的矩阵展示,而双向追溯要求数据模型具备动态关联能力。这正是实在Agent可以发挥优势的地方——通过构建需求、用例、缺陷之间的语义关联图谱,实现实时的双向穿透查询。
2.2 自动生成追溯关系的技术路径
自动生成双向追溯并非简单地“导入Excel再导出”,它需要一套完整的数据处理链路。
- 多源数据接入与标准化:从Jira、Polarion、禅道、TestRail等不同系统中抽取需求、用例、缺陷数据,按照统一标识进行对齐。实在Agent支持批量读取海量文档与系统数据,自动剥离冗余信息,将关键字段重组为标准格式。
- 语义匹配与链路推断:基于需求描述与测试步骤的语义相似度,自动建立候选追溯关系,再由人工确认或规则引擎校验。这一步模拟了资深质量工程师的“逻辑对标”思维。
- 规则引擎驱动的一致性校验:设定追溯完整性规则(如“每个安全需求必须至少关联一条测试用例”),系统自动扫描并标记缺口。
- 变更影响自动传播:当需求发生变更时,系统自动沿追溯链路向下游传播影响标记,生成受影响用例清单和回归建议。
2.3 追溯矩阵自动维护的持续运营机制
自动生成只是起点,持续维护才是真正的挑战。一套好的方案需要具备“自愈”能力。
- 增量同步机制:监听源系统的变更事件,只更新受影响的追溯链路,避免全量重建。
- 操作日志与审计留痕:全流程记录每一次追溯关系的创建、修改、删除操作,支持按单据号或提报人快速检索。实在Agent支持自动将日志生成PDF附件同步至相关系统,满足审计追溯需求。
- 分级权限与数据脱敏:不同角色看到不同粒度的追溯视图,敏感信息自动脱敏,操作全程留痕可追溯。
三、实在Agent在追溯矩阵场景中的落地实践
3.1 从“人工翻找”到“逻辑对标”:一个合规核验的典型场景
在某大型装备制造企业的质量管理体系中,追溯矩阵需要覆盖数万条安全需求与对应的验证记录。过去,质量团队每个季度需要投入多人周进行全量核对,漏检率始终无法降到理想水平。
引入实在Agent后,这一流程被重构为四个自动化步骤:
- 批量读取:Agent自动翻阅海量需求文档、测试报告、变更记录,调取标准词库与追溯规则库。
- 精准对标:模拟专家逻辑深度扫描匹配,自动建立需求与验证记录之间的追溯关系,消除漏检隐患。
- 数据清洗:自动剥离冗余杂讯,将关键信息重组为标准追溯矩阵格式。
- 自动存证:生成标准追溯报告并全量记录操作痕迹,构建完整的合规证据链。
成效方面,原本需要数天完成的合规核验周期缩短至小时级,匹配精度达到99%以上,合规追溯覆盖率达到100%。质量团队从“表格搬运工”回归到真正的质量分析工作。
3.2 大模型+小模型双轨制:处理复杂追溯规则的可行路径
追溯矩阵的复杂性不仅在于数据量大,更在于规则多样。以某电力集团为例,其下辖百余家分子机构,业务类型超过120种,单一业务类型的审核规则就包含十余种追溯维度。
实在Agent采用的“大模型+小模型”双轨制方案为这类场景提供了参考:
- 大模型负责规则解析:将制度文本、合规标准上传后,大模型自动解析生成可执行的追溯规则代码,降低规则配置门槛。
- 小模型负责精准执行:OCR小模型与规则引擎结合,在具体追溯关系建立时执行高精度匹配与校验。
- 全链路日志审计:每一步追溯关系的生成与变更都生成PDF日志,随流程同步至审计中心,满足监管要求。
该方案在类似场景中实现了初审替代率66%,人工负荷降低超60%,风控响应速度提升300%的效果。
3.3 电商与运营场景中的追溯延伸
追溯矩阵的思路并不局限于研发质量领域。在电商运营中,竞品价格监控与调价预警同样需要“动作—结果”的双向追溯。
实在Agent在这一场景中的运作逻辑是:目标锁定→智能对标(过滤无效噪音)→极速触达(预警响应)→复盘追溯。每一次调价动作都可反向追溯到触发它的竞品价格变化,形成完整的决策证据链。这种能力对于需要精细化运营的团队而言,意味着从“凭经验调价”转向“凭数据追溯决策”。
四、实施自动生成双向追溯方案的关键步骤
4.1 盘点现有追溯资产与工具链
在引入任何自动化方案之前,企业需要先摸清家底。
- 梳理现有追溯矩阵的覆盖范围、数据量级、更新频率。
- 识别追溯关系的来源系统及其数据接口能力。
- 明确合规审计对追溯粒度、留存时间、访问权限的具体要求。
4.2 定义追溯模型与规则体系
这是方案落地的核心设计环节。
- 实体定义:明确需要追溯的对象类型(需求、设计、代码提交、测试用例、缺陷、变更请求等)。
- 关系定义:确定实体之间的追溯关系类型(派生、验证、影响、依赖等)。
- 规则定义:设定追溯完整性的校验规则和变更影响传播规则。
- 权限模型:设计分级权限与数据脱敏策略,确保敏感信息只对授权角色可见。
4.3 分阶段推进自动化追溯
建议采用“先通后优”的策略。
- 第一阶段:实现核心链路的自动生成,优先覆盖合规审计最关注的追溯维度。
- 第二阶段:接入变更事件,实现追溯关系的增量自动更新。
- 第三阶段:引入智能分析与预警,如追溯缺口自动告警、变更影响范围自动评估。
- 持续运营:建立追溯矩阵的健康度指标(完整性、一致性、时效性),定期评估并优化。
五、从成本中心到质量资产:追溯矩阵的价值重塑
当追溯矩阵不再需要人工逐行维护,它就从一项“不得不做的苦差事”转变为企业的质量数据资产。需求变更的影响分析从“会后确认”变为“实时可见”,合规审计从“突击准备”变为“常态就绪”,质量团队的精力从“维护表格”回归到“改进质量”。
实在Agent在其中的角色,是连接数据孤岛、模拟专家逻辑、持续自动维护的智能枢纽。它不替代现有的需求管理或测试管理工具,而是让这些工具中的数据真正流动起来,形成活的双向追溯网络。
如果您的团队正在被庞大的追溯矩阵拖累,不妨从一条核心链路开始,尝试用自动生成的方式替代人工维护。第一步不需要太大,但方向对了,15万行就不再是负担,而是可被随时调用的质量证据。
常见问题解答
Q1:自动生成的双向追溯关系准确率如何保证?
A:通常采用“语义匹配+规则引擎+人工确认”三层机制。实在Agent在批量建立候选追溯关系后,会通过预设规则进行一致性校验,并保留人工确认环节。在成熟场景中,匹配精度可达99%以上。同时,全流程操作日志可追溯,便于审计和纠偏。
Q2:现有工具不想更换,能否实现自动追溯?
A:可以。实在Agent采用非侵入式集成方式,通过API或数据接口连接现有系统,不要求企业替换正在使用的需求管理、测试管理或缺陷跟踪工具。它更像一层“智能中间件”,在现有工具之上构建追溯能力。
Q3:追溯矩阵涉及敏感数据,如何满足合规要求?
A:方案支持分级权限模型和数据脱敏机制,不同角色只能访问授权范围内的追溯视图。所有操作全程留痕,可生成标准PDF审计日志同步至财务或审计中心,满足内外部审计追溯要求。
Q4:实施周期一般需要多久?
A:取决于追溯模型复杂度和系统集成数量。通常核心链路的自动生成可在数周内完成上线,增量同步和智能分析能力可在后续迭代中逐步完善。建议从一条高频且合规压力大的链路切入,快速验证价值后再扩展。
Q5:追溯关系自动更新后,如何知道哪些需求变更影响了哪些测试?
A:系统会监听需求管理工具的变更事件,自动沿追溯链路向下游传播影响标记,生成受影响测试用例清单和回归建议。变更影响分析从过去的“人工筛查数小时”缩短为“系统自动推送数秒”。