文献下载整理占科研大半时间?批量下载与图谱构建
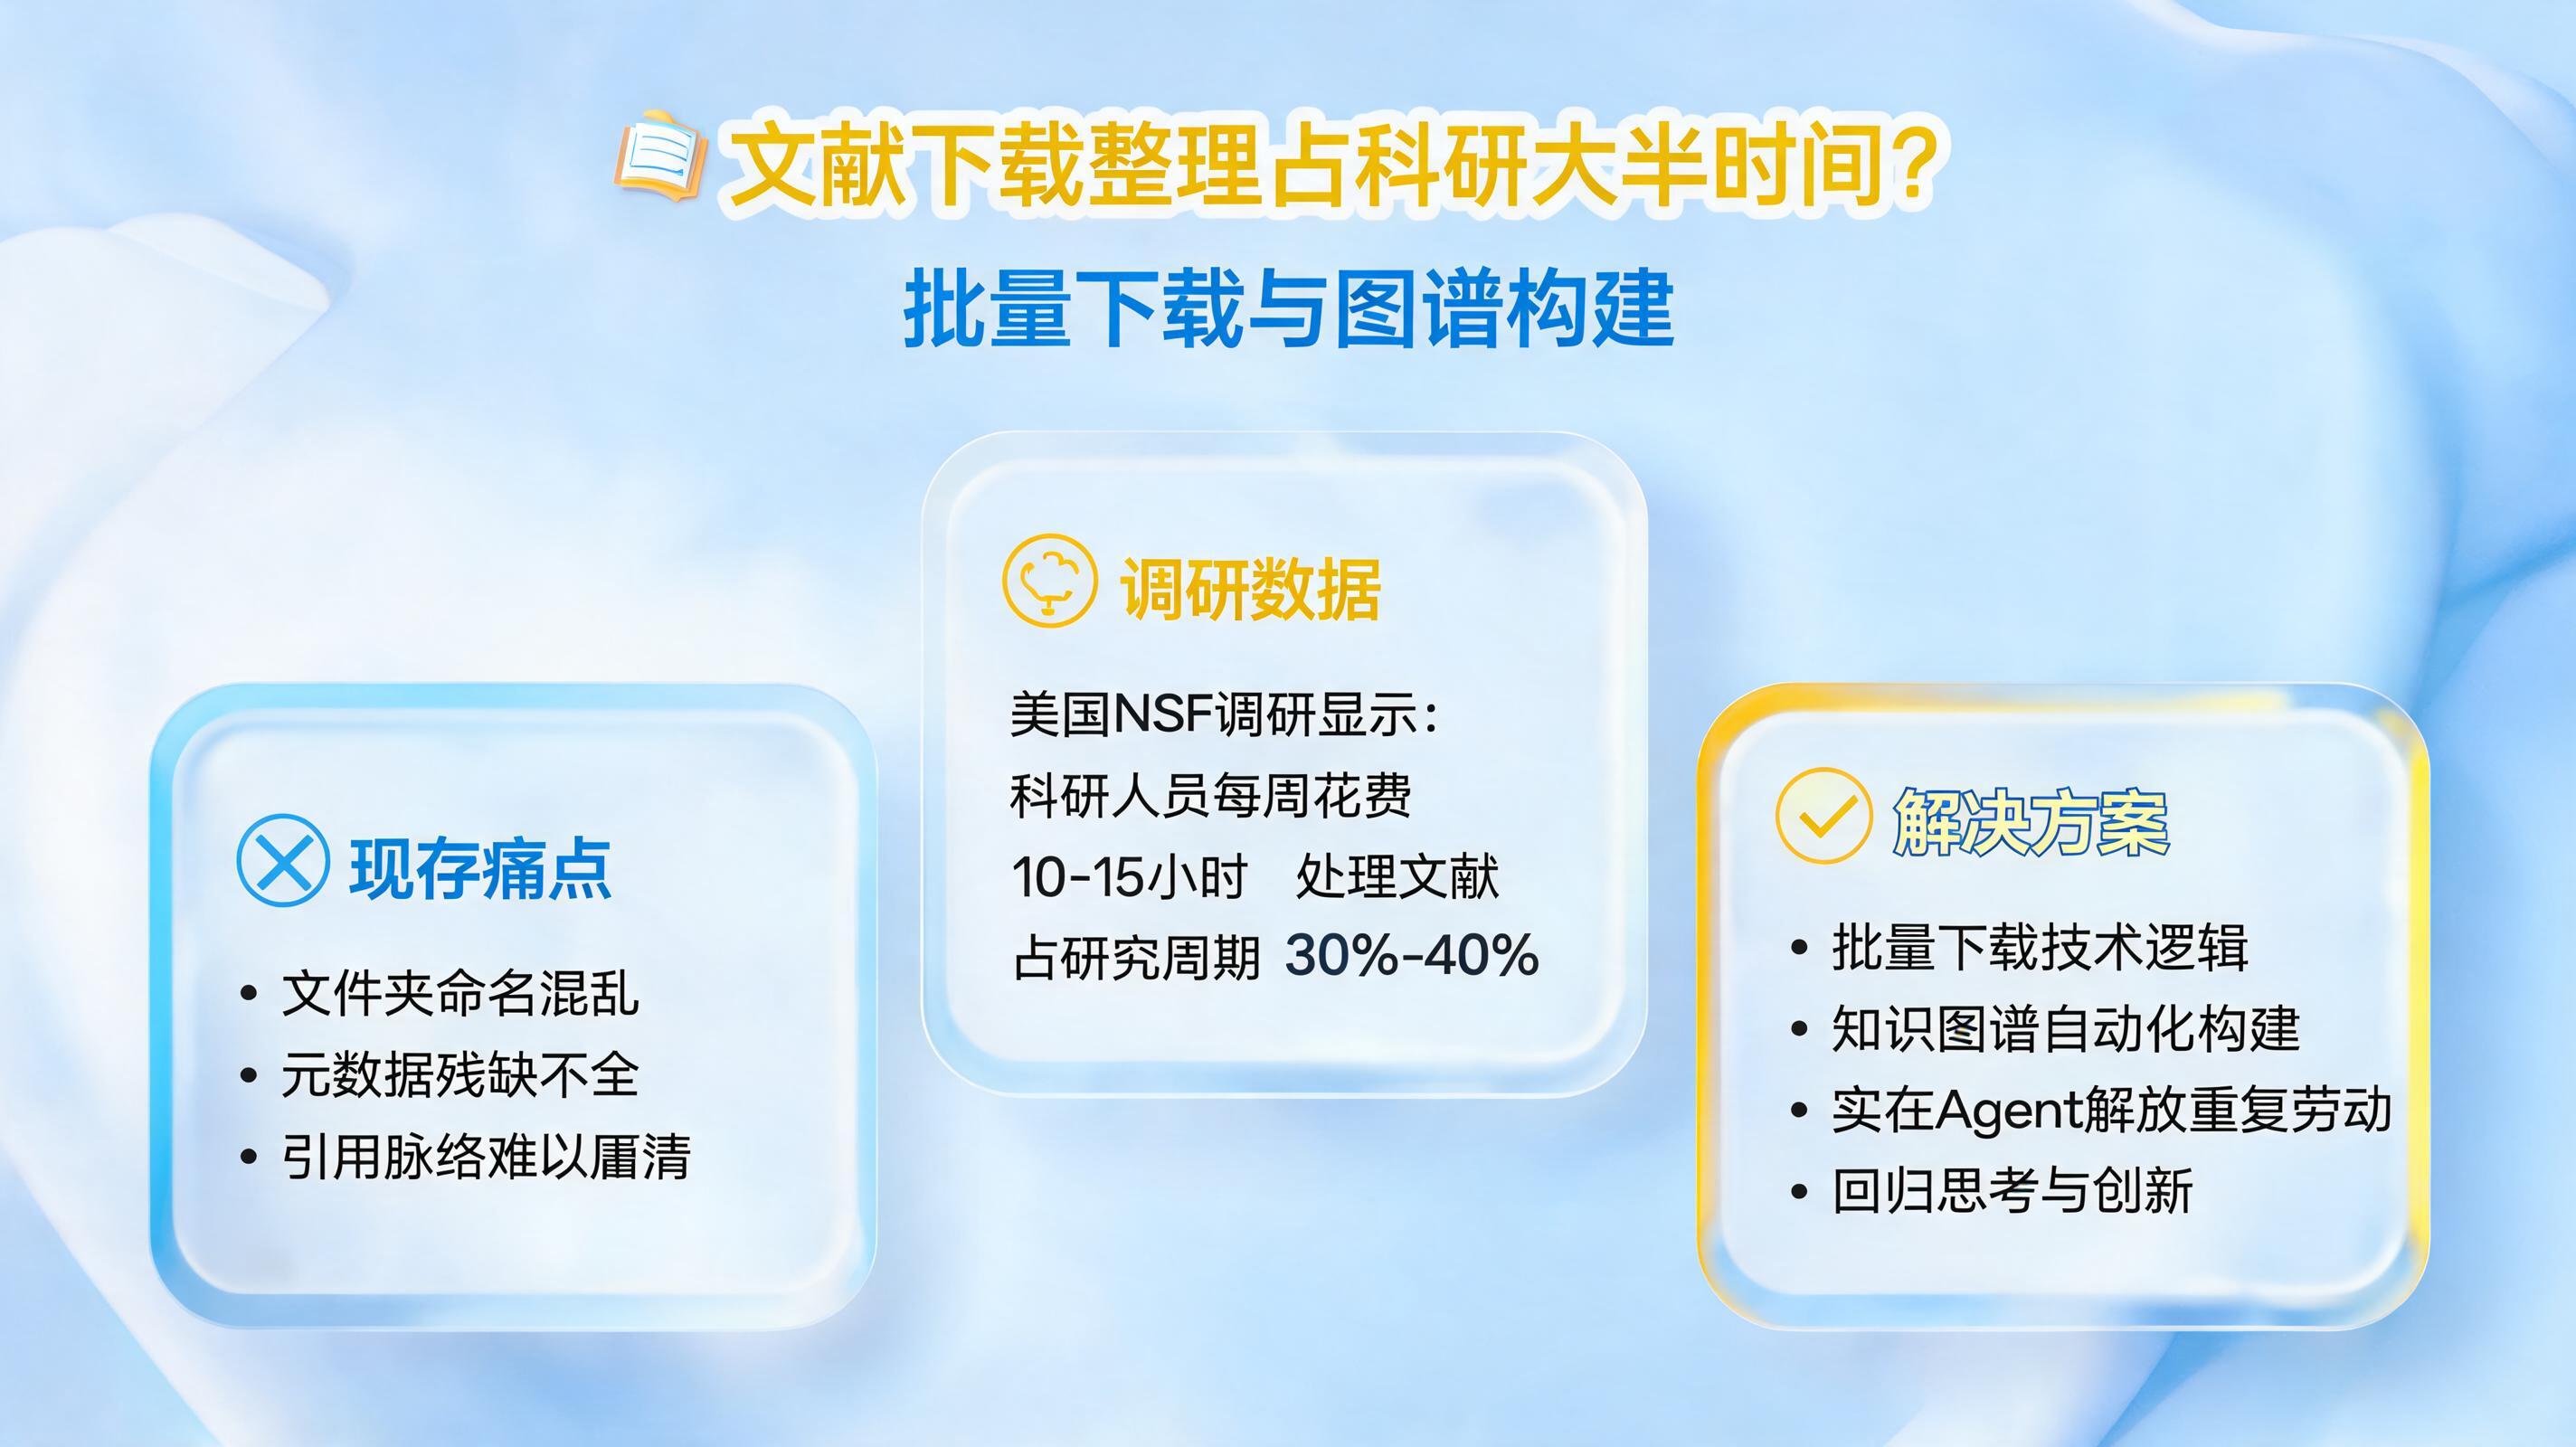
你有没有算过这样一笔账:一个科研工作者从确定选题到完成综述,究竟要花多少时间在“找文献”这件事上?根据美国国家科学基金会(NSF)的一项调研,科研人员平均每周要花费10到15个小时用于文献检索、下载、去重和格式化整理——这几乎占据了整个研究周期的30%到40%。更令人焦虑的是,当你好不容易从三大数据库下载了数百篇PDF,等待你的却是命名混乱的文件夹、残缺的元数据和难以厘清的引用脉络。
本文将带你重新审视文献处理的效率困局,从批量下载的技术逻辑讲到知识图谱的自动化构建,并解析实在Agent如何将科研人员从重复劳动中解放出来,把时间还给真正的思考与创新。
一、科研文献管理的“隐形时间黑洞”
1.1 为什么下载整理比读文献还累?
很多科研人员的真实体验是:读文献本身不累,累的是读之前的“准备动作”。一篇综述动辄需要涉及三五百篇文献,传统的工作流往往是这样的:
- 跨库检索繁琐:Web of Science、PubMed、IEEE Xplore、CNKI……每个平台的检索语法不同,导出格式各异,光是切换和重复输入关键词就消耗大量精力。
- 手动下载效率低下:点开一篇、点击下载、等待弹窗、重命名文件、按主题归档。面对几百篇的目标文献,单线程的人工操作极易导致任务堆积甚至卡死在中途。
- 元数据残缺:从不同数据库导出的文献信息字段不统一,作者名格式混乱、DOI缺失、期刊名缩写不一致,后续导入文献管理软件时错误百出。
- 版本与更新追踪困难:预印本、正式发表版、修订版散落在不同平台,稍不留神就引用了过时结论。
这些看似“不产生学术价值”的动作,正在悄悄吞噬科研人员最宝贵的深度思考时间。
1.2 批量下载不是“多选点下载”那么简单
很多人以为“批量下载”就是勾选全选然后点击下载按钮。但在实际的学术网络环境中,这个动作会面临一系列工程化挑战:数据库的反爬机制、并发请求的带宽瓶颈、文件命名与元数据的自动匹配、断点续传的稳定性……任何一个环节出问题,都可能导致下载任务前功尽弃。
这恰恰是实在Agent可以发挥价值的场景。通过自动化体检与多路并发技术,实在Agent能够将传统的“单线程下载”重塑为“极速并行流”,自动完成全域资源探测、调度分配、并行抓取和归档命名,实现从检索到入库的无人值守。类似的技术逻辑在电商素材批量采集场景中已经得到验证:整体交付效能提升300%,海量抓取成功率接近100%。
二、从批量下载到图谱构建的技术跃迁
2.1 自动化的第一步:让机器替你“跑腿”
要把科研人员从下载整理中解放出来,核心是构建一条从检索到归档的自动化流水线。这条流水线通常包含四个环节:
- 检索策略配置:设定关键词组合、时间范围、期刊分区、文献类型等过滤条件,Agent自动在多个数据库执行检索并合并结果。
- 智能去重与筛选:基于DOI、标题相似度和作者匹配算法,自动剔除重复条目,并根据预设规则(如被引量、发表年份)进行优先级排序。
- 多路并发下载:将待下载列表拆分为多个并行任务,模拟正常用户行为,规避封禁风险,同时支持断点续传和失败重试。
- 自动命名与归档:按照“年份-作者-标题”或自定义规则重命名文件,并同步抓取摘要、关键词、参考文献等元数据,直接生成可导入EndNote、Zotero的标准化文件。
通过实在Agent,这一整套流程可以实现全自动运行。科研人员只需要配置一次检索策略,剩下的下载、重命名、元数据抓取和归档工作都可以交给数字员工完成。原本需要数天才能完成的文献收集工作,可以压缩到数小时内交付。
2.2 知识图谱:让文献之间“自己连线”
下载只是起点,真正的效率飞跃发生在文献知识图谱的自动构建环节。所谓文献知识图谱,就是将文献中的作者、机构、关键词、引用关系、研究方法等实体抽取出来,构建成可视化的语义网络。它的价值在于:
- 快速定位核心文献:通过引用网络分析,自动识别出领域内的奠基性论文和关键综述,而不必凭感觉判断。
- 发现潜在合作者与机构:图谱可以揭示哪些团队在持续发表相关成果,为学术合作提供数据支撑。
- 追踪研究热点的演化路径:关键词共现网络能清晰展示某个研究方向从萌芽到爆发的完整脉络。
- 识别研究空白:当图谱中某个节点连接稀疏时,往往意味着该方向存在尚未被充分探索的机会。
传统上构建这样的图谱需要人工阅读大量文献并手动标注,工作量巨大。而借助实在Agent的文档理解与信息抽取能力,系统可以自动解析PDF全文,提取关键实体和关系,并输出可视化的图谱文件。某材料科学实验室在引入自动化图谱构建方案后,原本需要一名博士生花费两周完成的综述前期梳理工作,缩短至两天内完成,且信息遗漏率大幅降低。
三、实在Agent在科研场景中的落地实践
3.1 场景一:多数据库文献的批量极速采集
某高校新能源研究团队需要定期跟踪全球范围内关于钙钛矿太阳能电池的最新文献。过去,团队安排两名研究生轮流在各大学术平台手动检索下载,每周耗费约10人天,且经常出现漏检和重复下载的问题。
引入实在Agent后,团队配置了自动化采集流程:Agent每日定时在指定数据库执行检索,自动去重后并行下载新增文献,按照“期刊-年份-第一作者”规则归档,并同步生成包含摘要和关键词的Excel清单。整个流程无需人工干预,文献覆盖率和时效性显著提升。团队负责人反馈,节省下来的时间被重新分配到实验设计和数据分析上,课题推进速度明显加快。
3.2 场景二:从文献到图谱的一站式构建
另一家生物医药企业的情报分析部门面临着不同的挑战:他们需要从海量专利文献和学术论文中识别技术趋势,为研发决策提供依据。传统方式依赖人工阅读和Excel整理,不仅效率低,而且难以发现跨领域的隐性关联。
通过实在Agent,该部门搭建了自动化的文献图谱构建 pipeline:Agent批量下载目标文献后,自动进行全文解析,抽取化合物名称、靶点、适应症、实验方法等实体,构建知识图谱并定期更新。分析师只需在可视化界面上进行交互式探索,就能快速定位技术空白点和潜在竞争态势。原本需要数周的竞品情报分析报告,如今可以在几天内完成初稿。
3.3 场景三:跨系统文献数据同步与更新
对于已经使用文献管理软件的研究团队来说,另一个痛点是多设备、多系统之间的数据同步。某制造企业的研发中心需要将文献数据库与内部知识管理系统打通,确保工程师获取的技术资料始终是最新版本。
实在Agent通过自动化流程,定期从文献管理软件导出新增条目,校验元数据完整性后同步至企业知识库,并自动触发版本更新通知。这一过程完全替代了原来的人工导出导入操作,数据一致性和及时性得到根本保障。类似逻辑在制造业图纸版本同步场景中已有成熟应用,人工操作需要30分钟的任务,自动化后仅需5分钟,效率提升超过80%。
四、科研效率革命的下一步
当文献下载和整理不再占据科研人员的大半时间,真正的创新才拥有更广阔的土壤。从批量下载的“体力活”到知识图谱的“脑力活”,自动化技术正在重塑科研工作流的每一个环节。
未来,随着大模型对学术文本理解能力的持续增强,文献知识图谱将不再只是静态的结构化数据,而是能够主动推荐关联研究、预测趋势方向、甚至辅助假设生成的智能助手。对于科研团队和管理者而言,当下最务实的行动是:识别出工作流中最耗时且重复度最高的环节,用自动化工具率先替代它。文献的批量下载与图谱构建,正是那个投入产出比极高的切入点。
常见问题解答
Q1:批量下载文献会不会触发数据库的反爬机制,导致账号被封?
A:这是很多科研人员的顾虑。实在Agent在执行批量下载时,会模拟正常用户的访问频率和行为模式,支持请求间隔设置、IP轮换和并发控制。同时,建议优先使用机构订阅的正常访问权限,并遵守数据库的使用条款。在合规前提下,自动化工具可以显著提升效率而不触发风控。
Q2:构建文献知识图谱需要编程基础吗?
A:传统的图谱构建确实需要Python和NLP技术栈。但借助实在Agent的可视化流程配置,用户可以通过拖拽和参数设置完成文献解析、实体抽取和图谱生成,无需编写代码。对于有定制化需求的团队,也支持通过API进行深度集成。
Q3:实在Agent能处理中文文献和英文文献混合的场景吗?
A:可以。实在Agent支持中英文文献的混合处理,包括CNKI、万方等中文数据库和Web of Science、PubMed等英文数据库。在实体抽取和关键词归一化环节,系统会针对中英文分别采用适配的分词和语义模型,确保图谱质量。
Q4:文献图谱构建的准确率如何?会不会遗漏关键信息?
A:准确率取决于文献格式的规范程度和抽取字段的复杂度。对于标准学术论文(含清晰摘要、关键词和结构化全文),实体抽取的准确率通常可达90%以上。系统支持人工校验和修正环节,对于关键文献可以设置人工复核节点,确保重要信息不被遗漏。
Q5:这套方案适合个人科研工作者还是只适合大型团队?
A:两者都适合。个人研究者可以从简单的批量下载和自动归档功能入手,快速感受到效率提升;大型团队则可以部署完整的文献图谱构建和跨系统同步方案,实现团队级的科研知识管理。实在Agent支持从单机版到企业级的灵活部署方式。