RAG知识库建设:向量化+检索增强+热更新方案
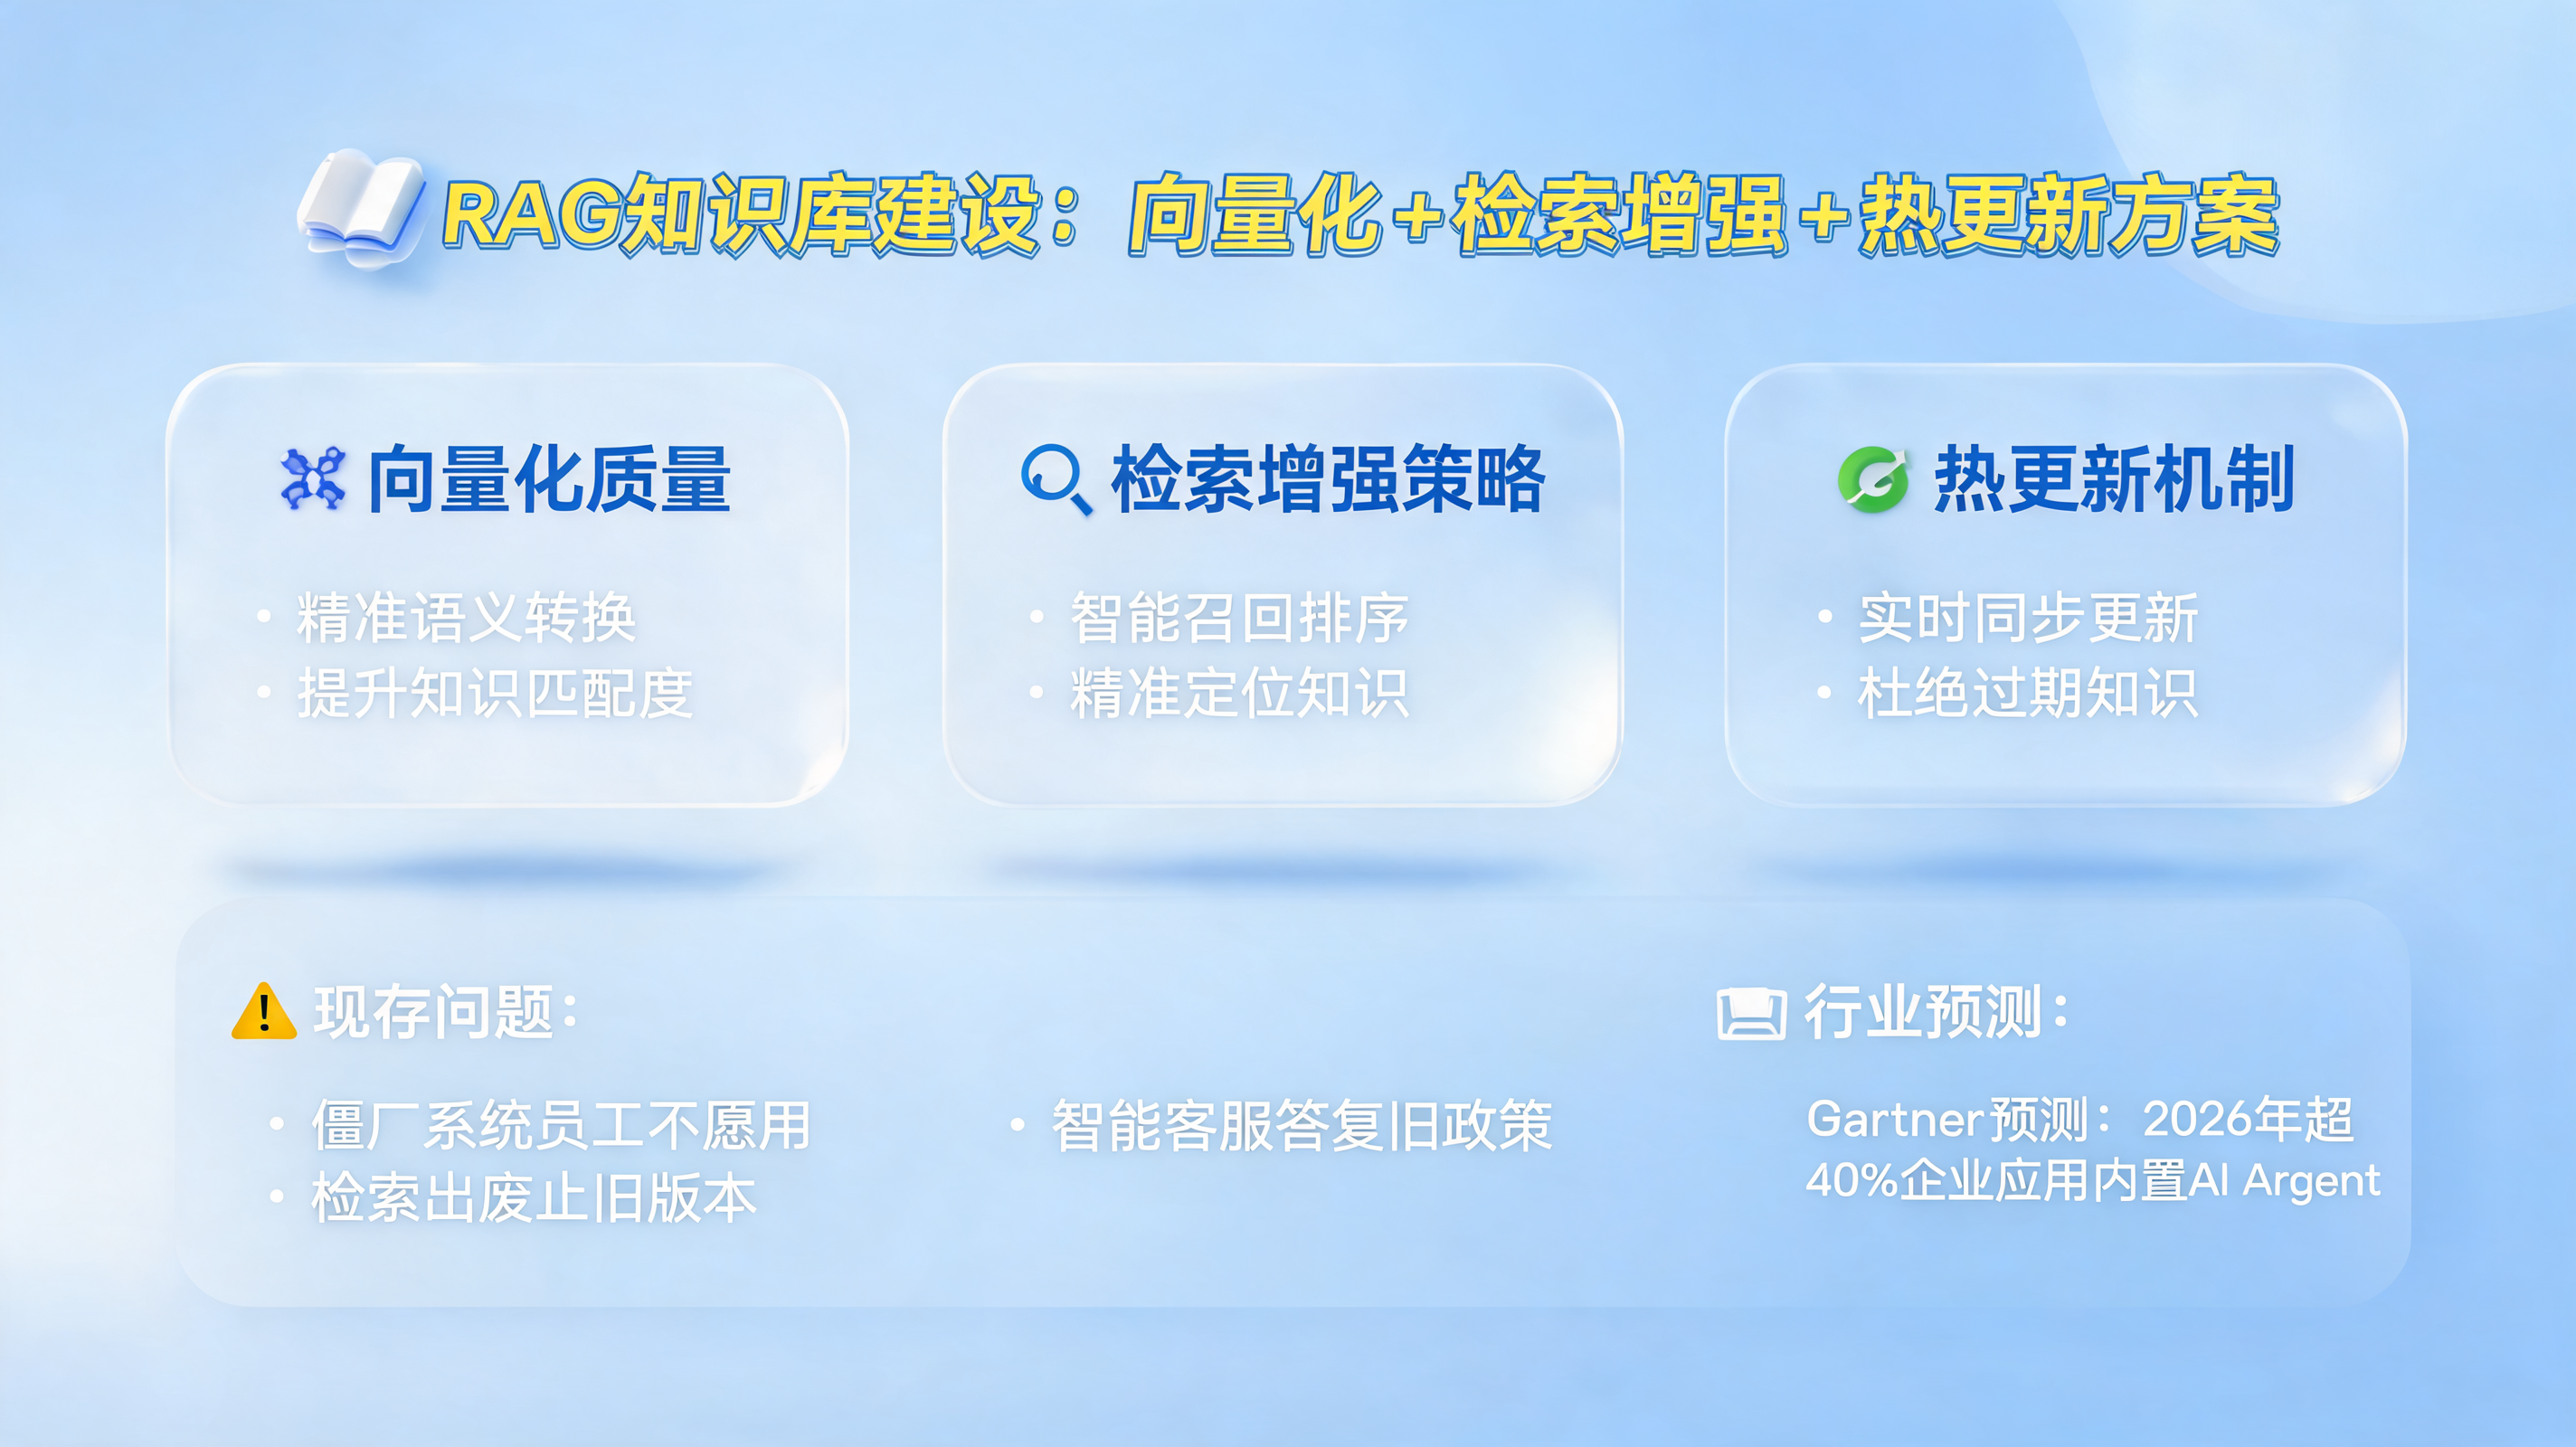
很多企业都经历过这样的场景:知识库项目上线时热热闹闹,半年后却成了"僵尸系统"——员工宁愿在群里@同事,也不愿打开那个问答入口;智能客服把三年前的旧政策当成现行标准答复客户;制度文档明明已经上传,检索出来的却是被废止的版本。问题往往不出在"有没有知识库",而在于知识库的向量化质量、检索增强策略和热更新机制这三根支柱是否扎实。Gartner曾预测,到2026年将有超过40%的企业应用内置AI Agent能力,而知识供给的准确性与时效性,正是决定这些智能体能否真正上岗的关键。本文就围绕"向量化+检索增强+热更新"这条主线,讲清楚企业级 RAG知识库建设 的完整方法、常见坑点与落地路线。
一、先看清问题:企业知识库为什么"建了就不管用"
1.1 三个典型症状
多数失败的知识库项目,都能对应到下面三种症状中的至少一种:
- 答不准:大模型"一本正经地胡说八道"。检索环节捞回来的文档和问题只是字面相似,语义不相关,模型只能靠自己的先验知识硬编答案。
- 答不全:答案散落在三份文档、两个系统和一张Excel表里。单路向量召回覆盖不到,缺少结构化数据与图文的联合检索。
- 答旧了:这是最隐蔽也最致命的一种。制度更新、价格调整、产品迭代之后,知识库仍是旧版本,业务人员被"权威地误导"一次,就会彻底失去信任。
1.2 RAG知识库建设的三根支柱
一套可长期运行的企业级RAG体系,本质是把三件事做扎实:
- 向量化:把文档、表格、图片、工单等异构知识,转成可被语义检索的向量表示,并保留来源、权限、时间等元数据。
- 检索增强:在生成之前,通过查询理解、多路召回、重排序等环节,把"最相关且合规"的上下文喂给大模型。
- 热更新:知识变更时,以增量方式更新索引,而不是推倒重来;同时支持版本回溯与效果评估。
实在Agent的RAG检索增强引擎,正是围绕这三个环节设计的,涵盖OCR能力管理、大模型管理、数据管理、提示词配置、检索优化与生成优化等模块,为企业提供从知识入库到答案输出的全链路能力。
二、向量化:知识进入大模型的"第一道关卡"
2.1 向量化到底在做什么
通俗地说,向量化就是给每一段知识"算坐标"。一段文字经过嵌入模型处理后,变成一个几百到几千维的数字数组;语义相近的内容,坐标距离就接近。用户在系统里提问时,问题同样被转换成坐标,系统找出距离最近的知识片段——这就是语义检索的基本原理。向量化做得好不好,直接决定了检索的"天花板"。
2.2 四个容易被忽略的工程细节
- 切分策略(Chunking):切得太碎会丢上下文,切得太大会引入噪声。制度类文档建议按条款切,合同类按要素与章节切,问答类按一问一答切,并保留标题层级作为上下文前缀。
- 嵌入模型选型:通用模型在中文长文本、专业术语、缩写混排场景下表现差异明显。金融、制造、医药等行业,建议用领域语料做微调或选用垂直模型。
- 元数据设计:每个向量片段都应带上来源系统、所属部门、生效日期、密级等标签。没有元数据的向量库,几乎无法做权限隔离与时效过滤。
- 多模态处理:企业里大量知识是扫描件、盖章合同、Excel台账和设备图纸。需要OCR、版面分析、表格结构还原等前置处理,才能进入向量化流程。
2.3 实在Agent在向量化环节的做法
通过实在Agent的RAG检索增强引擎,企业可以把OCR识别、大模型管理、数据加工和提示词配置放在同一套底座上完成,并支持私有化部署。底层的TARS大模型底座针对流程自动化、文档处理、数据分析等垂直场景做了专门优化,配合企业专属的向量数据库,让"入库—切分—嵌入—索引"这条链路可配置、可追溯。
三、检索增强:从"找到文档"到"答对问题"
3.1 一条完整的检索增强链路
检索增强不等于"向量检索+大模型"这么简单,完整的链路通常包含五个环节:
- 查询理解:识别用户真实意图,做同义改写、多轮指代消解、时间范围提取。
- 多路召回:向量召回负责语义近似,关键词召回负责专有名词与编号,结构化查询负责数值与统计口径。
- 重排序(Rerank):用交叉编码模型对候选片段重新打分,把真正相关的排到前面。
- 上下文组装:控制长度、去重、按来源标注,避免把相互矛盾的片段一起投喂。
- 生成与引用:要求模型基于给定上下文作答,并附带出处,让答案可核查。
3.2 企业场景必须处理的三件事
- 权限隔离:财务数据、人事薪酬、客户合同不能对全员可见。检索阶段就要按元数据过滤,而不是在生成阶段打补丁。
- 复杂版式与多语种:跨境业务合同、外文技术手册、盖章扫描件,需要多模态解析能力兜底。
- 与业务数据联动:很多问题一半在文档里,一半在数据库里——比如"这批票据的审批进度如何"。这时需要NL2SQL等能力与知识检索配合完成。
3.3 案例:千亿级供应链企业的合同风控知识库
某大宗商品供应链企业业务覆盖八十多个国家和地区,合同数量大、语种多,审查长期依赖个人经验。该企业采用"大模型+知识库+规则库"三位一体架构,由文件解析、关键信息抽取、规则引擎、合同审查等多类专业智能体协同作业。项目落地后,关键字段抽取量接近300个,要素抽取准确率达89%,基础录入效率提升90%以上;围绕72个标准化审核要点开展预审,预审准确率约85%;沉淀历史审核案例与专家经验超过10000条,形成了持续进化的企业专属知识资产。这套架构中,向量化负责把历史合同与审核意见变成可检索资产,检索增强负责把规则与案例精准送到审查环节,热更新则保证新法规、新内控要求当天可用。
四、热更新:让知识库"保鲜"的机制设计
4.1 为什么定期重建索引不是答案
不少团队的做法是"每周全量重建一次索引"。这在数据量小时尚可,一旦文档规模上到十万级,重建耗时会从分钟级涨到小时级,期间检索结果不稳定;更麻烦的是,重建往往由运维手动触发,知识更新与业务节奏脱节。
4.2 三种主流的增量更新路径
- 增量向量化与索引合并:只对新增、修改的文档重新切分与嵌入,追加进向量库,避免全量重算。
- 状态标记与优先级:给片段打上"生效/失效/待确认"状态与权重,检索时优先返回生效版本,失效内容降权或过滤。
- 版本快照与回滚:保留知识版本,出问题时能快速回退到上一个稳定状态,这对合规要求高的行业尤其重要。
4.3 把更新动作写进业务流程里
最好的热更新不是"额外派个人去维护",而是让更新成为业务动作的副产品。例如合同审核过程中,人工修正的字段、新增的风险判定、专家的批注,都可以自动回流到知识库;一线员工反馈"答错了"的问题,也应形成待办,进入知识运营的闭环。通过实在Agent,企业可以把文档处理、流程办理与知识沉淀串起来——审批流结束的那一刻,新的经验已经进入向量库并生效。
五、落地路线图:四步走,别一步到位
5.1 第一步:选一个"高频+高价值"的切入场景
不建议一上来就做全公司知识中台,可优先选择合同审查、IT工单处理、财务票据问答、电商售后政策咨询这类问题密度高、答案边界清晰的场景,快速验证效果。
5.2 第二步:数据治理与向量化
明确知识来源系统、更新责任人和密级规则,完成文档清洗、切分策略设计与嵌入模型选型。这一阶段往往占项目一半以上的工作量,值得投入。
5.3 第三步:建立评估集,量化调优
准备100—300条真实问题及标准答案,形成回归测试集,持续跟踪召回率、答案准确率、引用正确率等指标。调优的重点通常在切分粒度、召回路数和重排模型上。
5.4 第四步:热更新机制与运营岗位
把增量更新、版本管理、效果评估固化为流程,并明确一个知识运营角色。技术上线只是开始,持续运营才决定知识库的寿命。
六、案例拆解:当RAG接入业务系统
某新能源车企在财经资金、供应链与工厂管理等多个领域推行业务自动化,采用四层全域架构完成私有化部署:底层是自研大模型、向量数据库、票据OCR与机器人执行器;上一层是RPA流程自动化、RAG知识库、智能问数与Agent自主决策;再往上是打通的财务、供应链、经销商与协同系统;最上层是低代码业务编排。在承兑汇票审批场景中,系统完成AI自动初审、异常归集、精准触达与自动回填,财务流程自动化率达95%,每月80小时的工作量缩短至10小时,自动化流程处理准确率100%,覆盖财务部门90%以上的高频重复场景。值得注意的是,票据规则、差旅标准、报销制度等知识的更新,正是通过知识库的热更新机制同步到问答助手与审批流程中,避免了"制度改了、机器人还按老规矩办"的问题。
结语
RAG知识库不是一次性交付的软件,而是一项需要持续运营的能力资产。向量化决定了它的知识底座有多宽,检索增强决定了它的答案有多准,热更新决定了它的寿命有多长。对企业而言,与其追求"大而全"的知识中台,不如从一个高频场景切入,把这三件事做扎实,再逐步扩展。当知识能自动更新、答案能溯源核查时,知识库才真正从"成本项"变成"生产力"。
常见问题解答
问题1:RAG知识库建设一定要用向量数据库吗?
多数场景下建议使用。向量数据库负责语义检索,是处理非结构化文档的主力。但完整的检索体系通常是"向量+关键词+结构化查询"的混合架构,单纯依赖向量召回,在专有名词、编号、数值类问题上容易失效。
问题2:热更新会不会导致检索结果不稳定?
设计得当不会。关键在于增量更新要保证原子性:新片段写入并生效后,旧片段才被标记失效,中间不存在"两边都查不到"的窗口期。同时建议保留版本快照,出现异常时可快速回滚。
问题3:知识库内容涉及商业机密,能私有化部署吗?
可以。企业级方案通常支持本地化部署,向量数据库、大模型与检索服务全部运行在企业内网,并通过元数据权限控制实现部门级、角色级的可见范围隔离。实在Agent支持私有化企业级部署,适合对数据合规要求较高的行业。
问题4:怎么衡量一个知识库到底好不好用?
建议同时看三类指标:技术指标(召回率、重排准确率)、业务指标(问题解决率、人工转接率、平均处理时长)和运营指标(知识更新时效、失效内容占比、用户反馈闭环率)。只看问答次数,很容易被虚假繁荣误导。