代码追溯矩阵自动化:需求-代码-测试双向对齐
你是否经历过这样的场景:距离合规审计还有两周,质量部门发来一张Excel表格,要求你证明“每一条需求都已经实现、每一条代码变更都有测试覆盖、每一个测试用例都能追溯到原始需求”。于是,整个研发团队放下手头工作,埋头翻Jira、查Git提交记录、比对测试管理平台,耗时数天后交出一份“看起来完整”的追溯矩阵——但所有人心里都清楚,这份矩阵的准确性经不起深究。
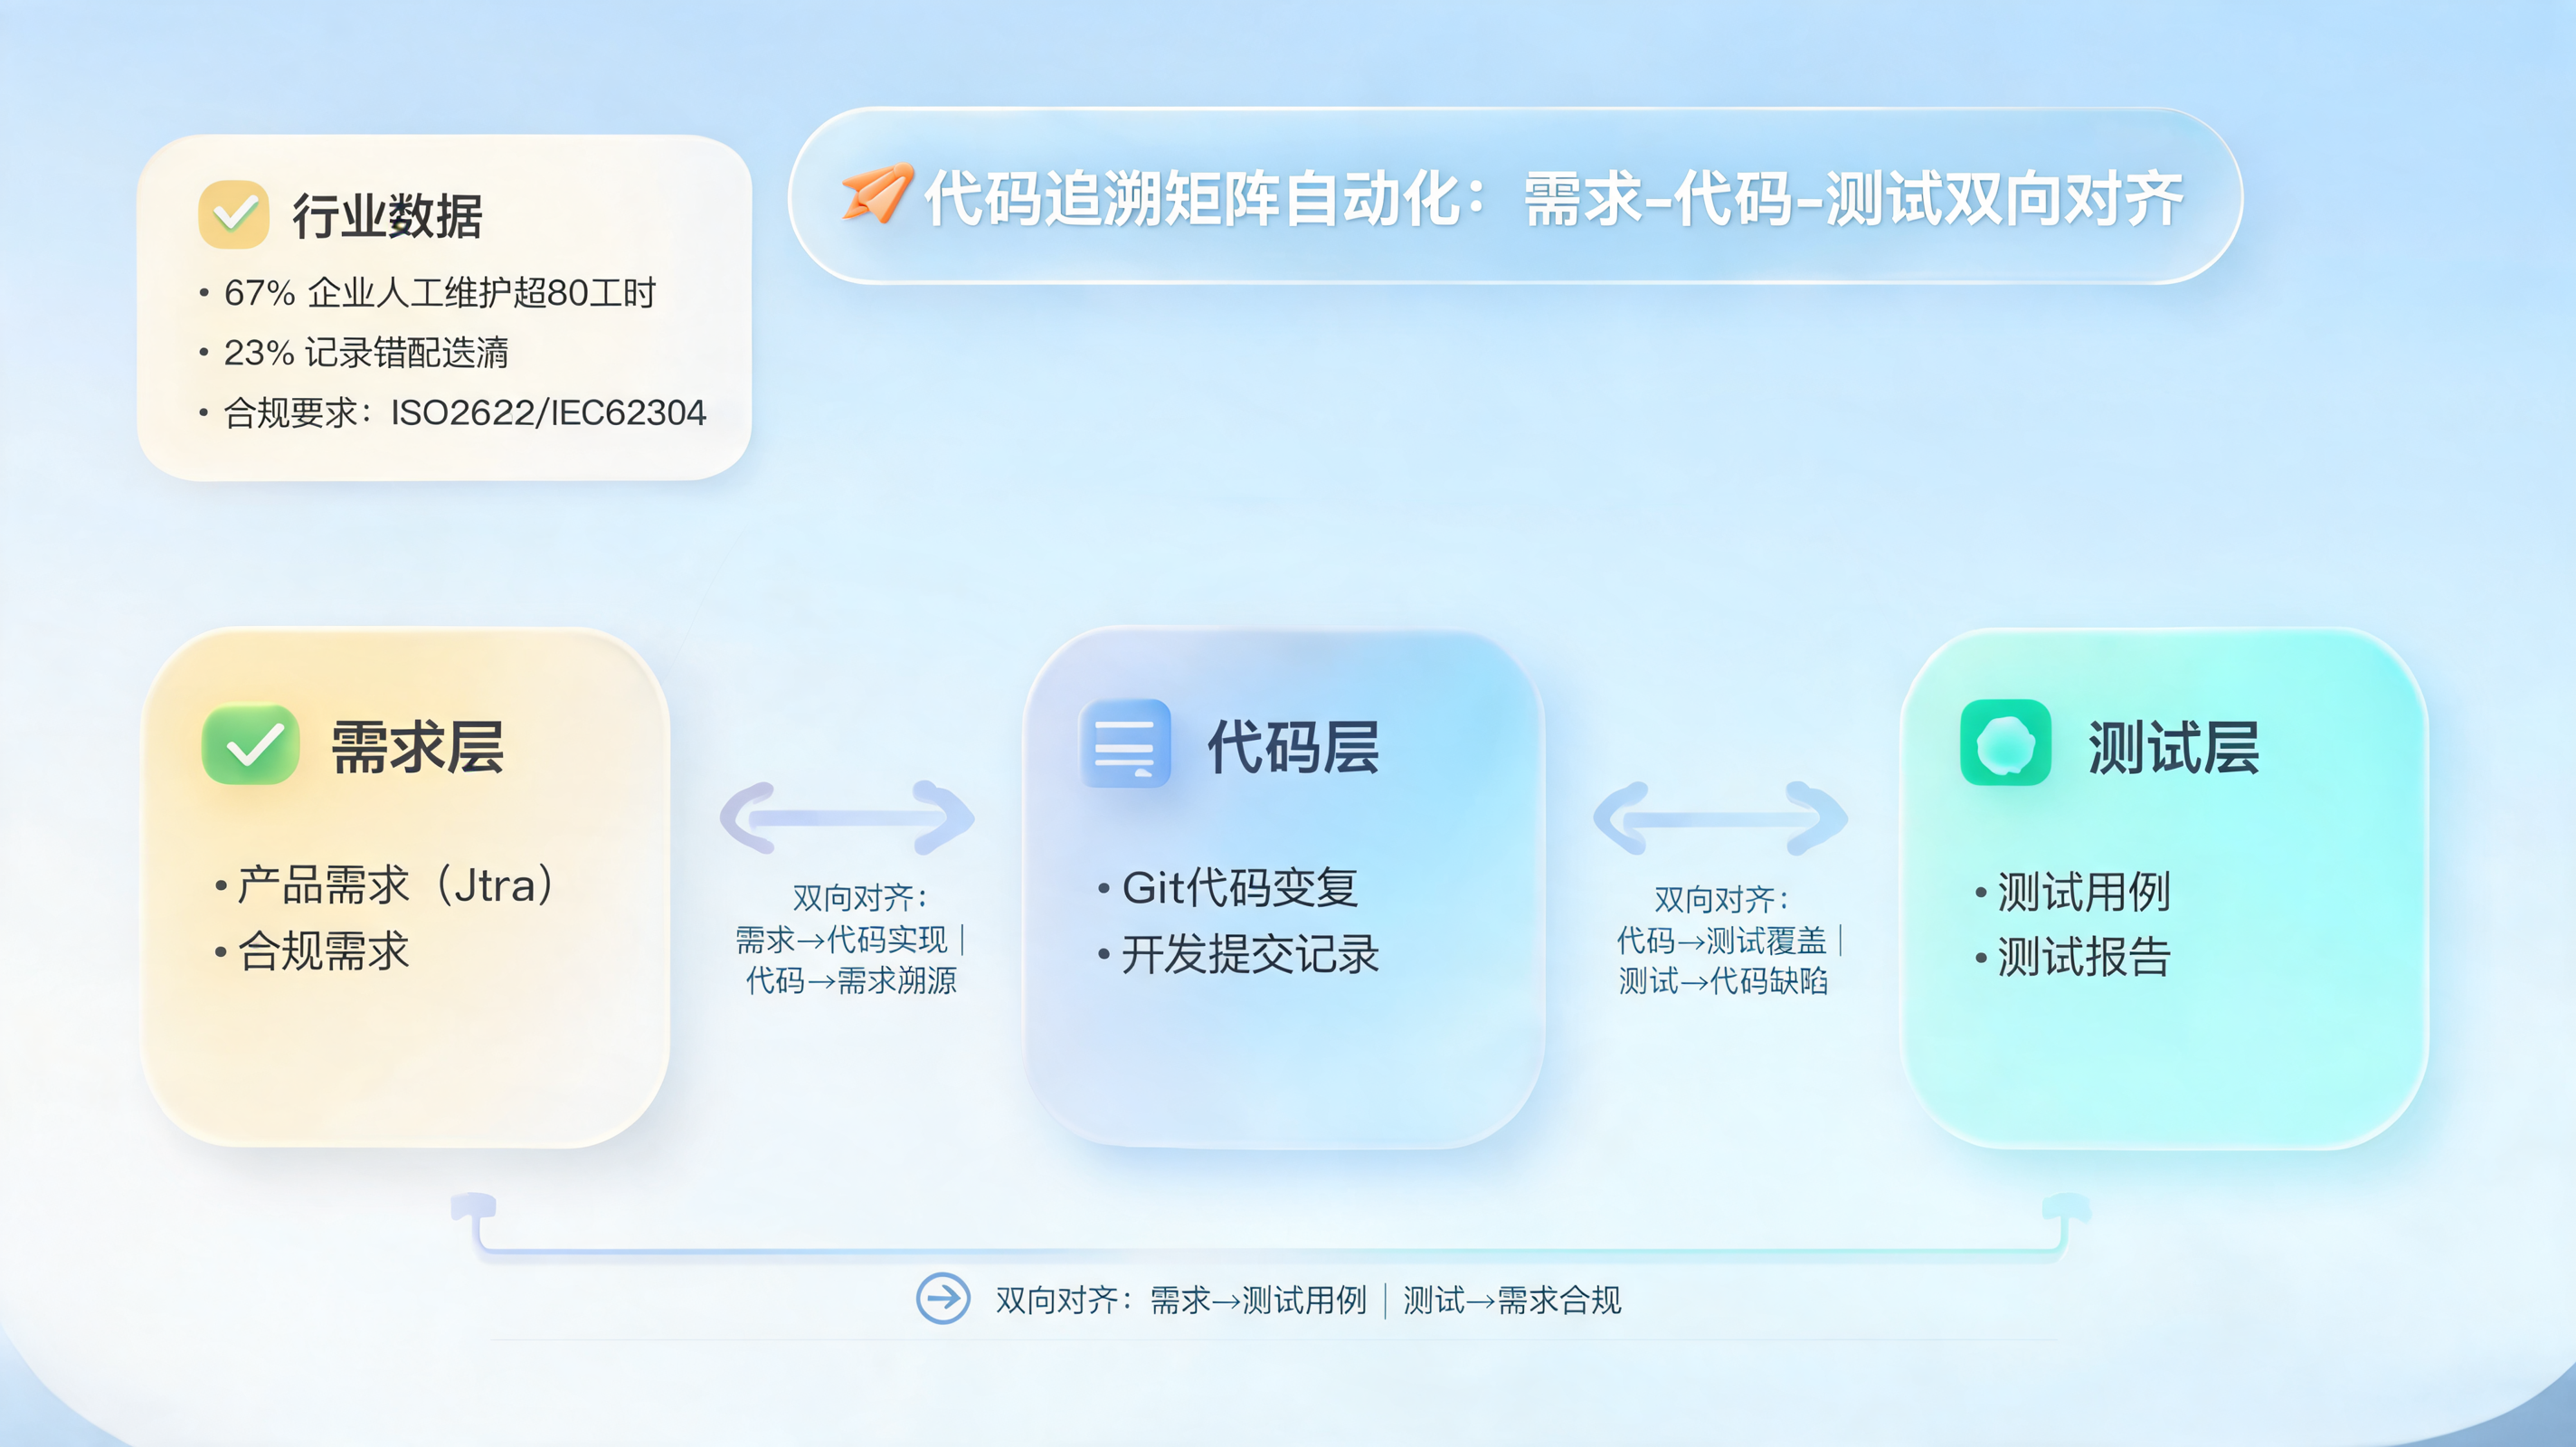
这并非个例。根据IDC发布的《2024年全球DevOps与软件质量报告》,超过67%的企业在合规审计或重大版本发布前,仍需投入超过80个工时用于人工维护需求追溯矩阵,而其中约23%的追溯记录存在不同程度的遗漏或错配。在汽车电子、医疗器械、金融科技等强监管行业,这一问题尤为突出——ISO 26262、IEC 62304、DO-178C等标准都对需求-代码-测试的双向追溯提出了明确要求。
本文将系统性地探讨:代码追溯矩阵自动化的核心逻辑是什么?如何借助AI智能体实现需求、代码、测试三者之间的双向对齐?以及在落地过程中,企业应该关注哪些关键节点。
为什么传统追溯矩阵总是“对不齐”?
在讨论自动化方案之前,有必要先理解传统追溯矩阵失效的根本原因。
1.1 追溯关系的“三断点”
大多数研发团队的追溯链路存在三个天然断裂点:
- 需求到代码的断点:产品经理在需求管理工具中写下需求,开发工程师在IDE中写代码,两者之间往往只靠一句“关联需求ID”的提交注释来维系。一旦注释遗漏或写错,追溯链就断了。
- 代码到测试的断点:单元测试、集成测试、端到端测试分散在不同的框架和平台中,测试用例与代码分支的映射关系缺乏强制约束。代码重构后,测试映射往往未能同步更新。
- 测试到需求的断点:测试人员依据需求文档设计用例,但需求变更后,哪些测试用例需要同步修改?这个问题在快速迭代中几乎无法人工回答。
1.2 人工维护的“不可能三角”
企业在维护追溯矩阵时,始终面临质量、效率、成本的不可能三角:
- 追求完整性:需要专人逐条核对,耗时巨大,且容易出现“为了交差而补记录”的形式主义。
- 追求时效性:在敏捷迭代中,追溯矩阵更新速度永远落后于代码变更速度。
- 追求准确性:人工比对容易产生遗漏,尤其在需求数量超过500条、代码提交超过10万次的中大型项目中,错误率呈指数级上升。
>Gartner在2024年的一项研究中指出,到2027年,超过40%的企业将采用AI驱动的自动化追溯工具来替代人工维护追溯矩阵,以应对日益严苛的合规要求和快速交付压力。>代码追溯矩阵自动化的核心能力拆解
那么,自动化的追溯矩阵究竟应该具备哪些能力?它不仅仅是“把Excel搬到系统里”,而是要从根本上重构追溯关系的建立、维护和验证方式。
2.1 双向对齐:从“单向记录”到“双向校验”
传统矩阵往往是“需求→代码→测试”的单向记录,而自动化系统需要实现真正的双向对齐:
- 正向追溯:给定一条需求,系统能自动列出实现该需求的代码提交、关联的测试用例及最新执行结果。
- 反向追溯:给定一行代码或一个测试用例,系统能自动回溯到它对应的需求条目,并判断是否存在“孤儿代码”或“冗余测试”。
- 变更影响分析:当需求发生变更时,系统自动识别受影响的代码模块和测试用例,并推送给相关责任人。
实在Agent在这一环节可以发挥关键作用。通过TARS大模型的深度规划能力,实在Agent能够理解需求文本的语义,自动匹配代码仓库中的提交记录和测试管理系统中的用例,构建起动态更新的追溯图谱,而不是依赖人工标注的静态映射。
2.2 自动化采集:打通工具链的“最后一公里”
追溯矩阵自动化的前提是数据采集的自动化。这要求系统能够:
- 对接主流研发工具:包括Jira、PingCode、TAPD等需求管理工具,GitLab、GitHub、Gitee等代码托管平台,以及TestRail、Zephyr、MeterSphere等测试管理平台。
- 处理非结构化数据:很多遗留系统中,需求描述、测试记录以文档或邮件形式存在,需要OCR和NLP技术进行信息抽取。
- 支持私有化部署:对于金融、军工等对数据安全要求极高的行业,追溯数据不能出内网。
实在Agent的“信创龙虾”能力在此场景下尤为适用——全面适配国产软硬件环境,支持私有化部署,确保追溯数据的全链路安全可控。同时,通过ISSUT智能屏幕语义理解技术,实在Agent可以直接操作那些没有开放API的老旧研发工具,实现“视觉+底层”融合拾取,无需等待工具改造。
2.3 实时校验与告警:让追溯关系“活起来”
自动化追溯矩阵不应是一份静态报告,而应是一个动态监控系统:
- 提交时校验:开发人员提交代码时,系统自动检查是否关联了需求ID,是否缺少必要的测试覆盖,不通过则阻断提交。
- 构建时校验:在CI/CD流水线中嵌入追溯校验环节,如果发现某条需求没有对应的测试用例,或某个测试用例没有关联需求,自动触发告警。
- 发布前校验:版本发布前,自动生成完整的追溯矩阵报告,标记所有“未闭环”的追溯项,供质量门禁决策。
AI智能体如何重构追溯矩阵的工作流?
理解了核心能力后,我们来看一个典型的自动化追溯矩阵工作流是如何运转的。
3.1 需求解析与语义建模
当产品经理在需求管理系统中创建或更新一条需求时,实在Agent可以自动读取需求文本,利用大模型进行语义分析,提取出关键的功能点、约束条件和验收标准。这些结构化信息成为后续匹配代码和测试的“锚点”。
例如,一条需求描述为“用户登录时支持手机号+验证码方式,验证码有效期5分钟,错误3次锁定账户”,实在Agent可以自动拆解出“手机号登录”、“验证码校验”、“有效期控制”、“错误锁定”四个功能点,并分别建立追溯节点。
3.2 代码提交的智能关联
开发人员提交代码时,往往只写一句“fix bug”或“update”。实在Agent可以通过分析代码变更的语义(如修改了哪个模块、涉及哪些函数、commit message中的关键词),自动推荐关联的需求条目,供开发人员确认。这大大降低了人工关联的负担,同时提高了准确性。
对于未关联的代码提交,系统会自动标记为“待追溯”,并在每日站会报告中提醒团队处理。
3.3 测试用例的自动映射
测试管理平台中的用例通常包含“前置条件”、“操作步骤”、“预期结果”等字段。实在Agent可以基于语义相似度,自动将测试用例与需求条目进行匹配,并识别出:
- 完全覆盖:测试用例完整验证了需求的所有功能点。
- 部分覆盖:测试用例只覆盖了部分功能点,需要补充。
- 过度测试:测试用例关联了已废弃的需求,需要清理。
3.4 变更影响链的自动传导
当需求发生变更时,实在Agent自动触发影响分析:
- 识别受影响的代码模块(通过追溯图谱反向查询)。
- 识别受影响的测试用例(通过需求-测试映射关系)。
- 生成变更影响报告,推送给开发、测试和产品负责人。
- 在变更完成后,自动更新追溯矩阵的状态。
这一过程将原本需要数天的人工分析压缩到分钟级,且避免了遗漏。
落地实践:从“合规驱动”到“效能驱动”
很多企业启动追溯矩阵自动化的初衷是为了应对审计,但真正做得好的团队会发现,它带来的效能提升远超预期。
4.1 典型场景:某金融科技企业的合规审计提速
某金融科技企业需要满足银保监会的系统变更审计要求,每次版本发布前需提交完整的追溯矩阵。过去,由两名质量工程师专职维护,每次审计准备耗时约15个工作日。
引入实在Agent后,该企业实现了以下自动化流程:
- 需求管理系统中的每条需求自动同步至追溯平台。
- 代码提交时自动关联需求ID,未关联的提交无法合并至主分支。
- 测试用例自动映射至需求,覆盖率实时计算。
- 审计前一键生成符合监管格式的追溯矩阵报告,附带完整的操作日志和审计追踪。
结果是:审计准备时间从15个工作日缩短至2个工作日,追溯记录的准确率从人工时代的约85%提升至99%以上,且质量工程师可以将精力转移到测试策略优化等更高价值的工作上。
4.2 制造业嵌入式软件的追溯实践
在汽车电子领域,某零部件供应商需要满足ISO 26262功能安全标准,对需求-代码-测试的追溯要求极为严格。该企业的研发工具链涉及多个老旧系统,部分工具甚至没有API接口。
通过实在Agent的ISSUT视觉拾取能力,企业无需改造老旧系统,即可实现跨工具的追溯数据采集。同时,实在Agent的“安全龙虾”能力提供了精细化的权限隔离和全链路可溯源审计,确保追溯数据在采集、传输、存储全过程中的安全性。
4.3 关键成功要素
从这些实践中,可以总结出几条关键经验:
- 工具链打通是基础:追溯矩阵自动化不是孤立系统,需要与现有研发工具链深度集成。实在Agent的开放接入能力(支持API、MCP及多技能调用)在这方面具有明显优势。
- 渐进式推进:不必追求一次性覆盖所有项目,可以先从合规要求最紧迫的核心项目试点,再逐步推广。
- 度量驱动优化:建立追溯覆盖率、追溯时效性等指标,持续监控并优化。
- 人机协同:自动化不是完全取代人工,而是将人工从繁琐的比对工作中解放出来,专注于异常处理和规则优化。
未来趋势:从追溯矩阵到研发知识图谱
代码追溯矩阵自动化的终极形态,不是一张更大的Excel表,而是一个动态的、语义化的研发知识图谱。
在这个图谱中,需求、代码、测试、缺陷、变更、人员等节点相互连接,形成一个可推理、可查询、可预测的智能网络。当新需求进入时,系统能自动推荐相似的历史实现和测试用例;当代码变更时,系统能预测潜在的回归风险;当缺陷发生时,系统能快速定位根因。
实在Agent的“企业龙虾”能力——开箱即用、高并发、高稳定——正是为这种企业级知识图谱场景而设计。通过多智能体协同,实在Agent可以调度复杂跨系统任务,让追溯矩阵不再是静态的合规文档,而是研发效能持续提升的引擎。
常见问题解答
Q1:代码追溯矩阵自动化与传统的需求管理工具(如Jira)有什么区别?
Jira等工具主要解决需求的录入、流转和状态管理,而追溯矩阵自动化聚焦于需求、代码、测试三者之间关系的自动建立、校验和维护。前者是“管需求”,后者是“管关系”。实在Agent可以与Jira等工具无缝集成,在其基础上增加自动追溯的能力。
Q2:我们的研发工具很多是老旧的,没有API,能做自动化追溯吗?
可以。实在Agent的ISSUT智能屏幕语义理解技术,可以通过“视觉+底层”融合拾取的方式,直接操作没有API的老旧工具界面,实现数据采集和操作自动化。这意味着企业无需等待工具改造或替换,即可启动追溯矩阵自动化。
Q3:追溯矩阵自动化会不会增加开发人员的工作负担?
恰恰相反,它的目标是减轻负担。开发人员只需在提交代码时确认系统推荐的关联需求,无需手动填写繁琐的追溯信息。测试人员也无需人工维护需求-测试映射表。根据已落地企业的反馈,开发人员在追溯相关事务上的时间投入平均减少70%以上。
Q4:如何衡量追溯矩阵自动化的ROI?
可以从三个维度衡量:一是合规审计准备时间的缩短(通常从数周降至数天);二是追溯记录的准确率提升(从人工的80%-90%提升至99%以上);三是研发团队在追溯事务上的工时节省。综合来看,多数企业在6-12个月内即可收回投入成本。
Q5:实在Agent在追溯矩阵自动化场景中,最核心的优势是什么?
三个层面:第一,TARS大模型提供深度的语义理解和任务规划能力,能准确匹配需求、代码和测试之间的语义关系;第二,ISSUT+RPA融合拾取能力,能操作无API的老旧系统和信创全终端,解决工具链打通的“最后一公里”问题;第三,全链路可溯源审计和精细化权限隔离,满足金融、军工等行业的严苛安全要求。