电厂工作票操作票智能审查:安规规则引擎自动校验技术指南
2026-09-17 16:21:21阅读 3
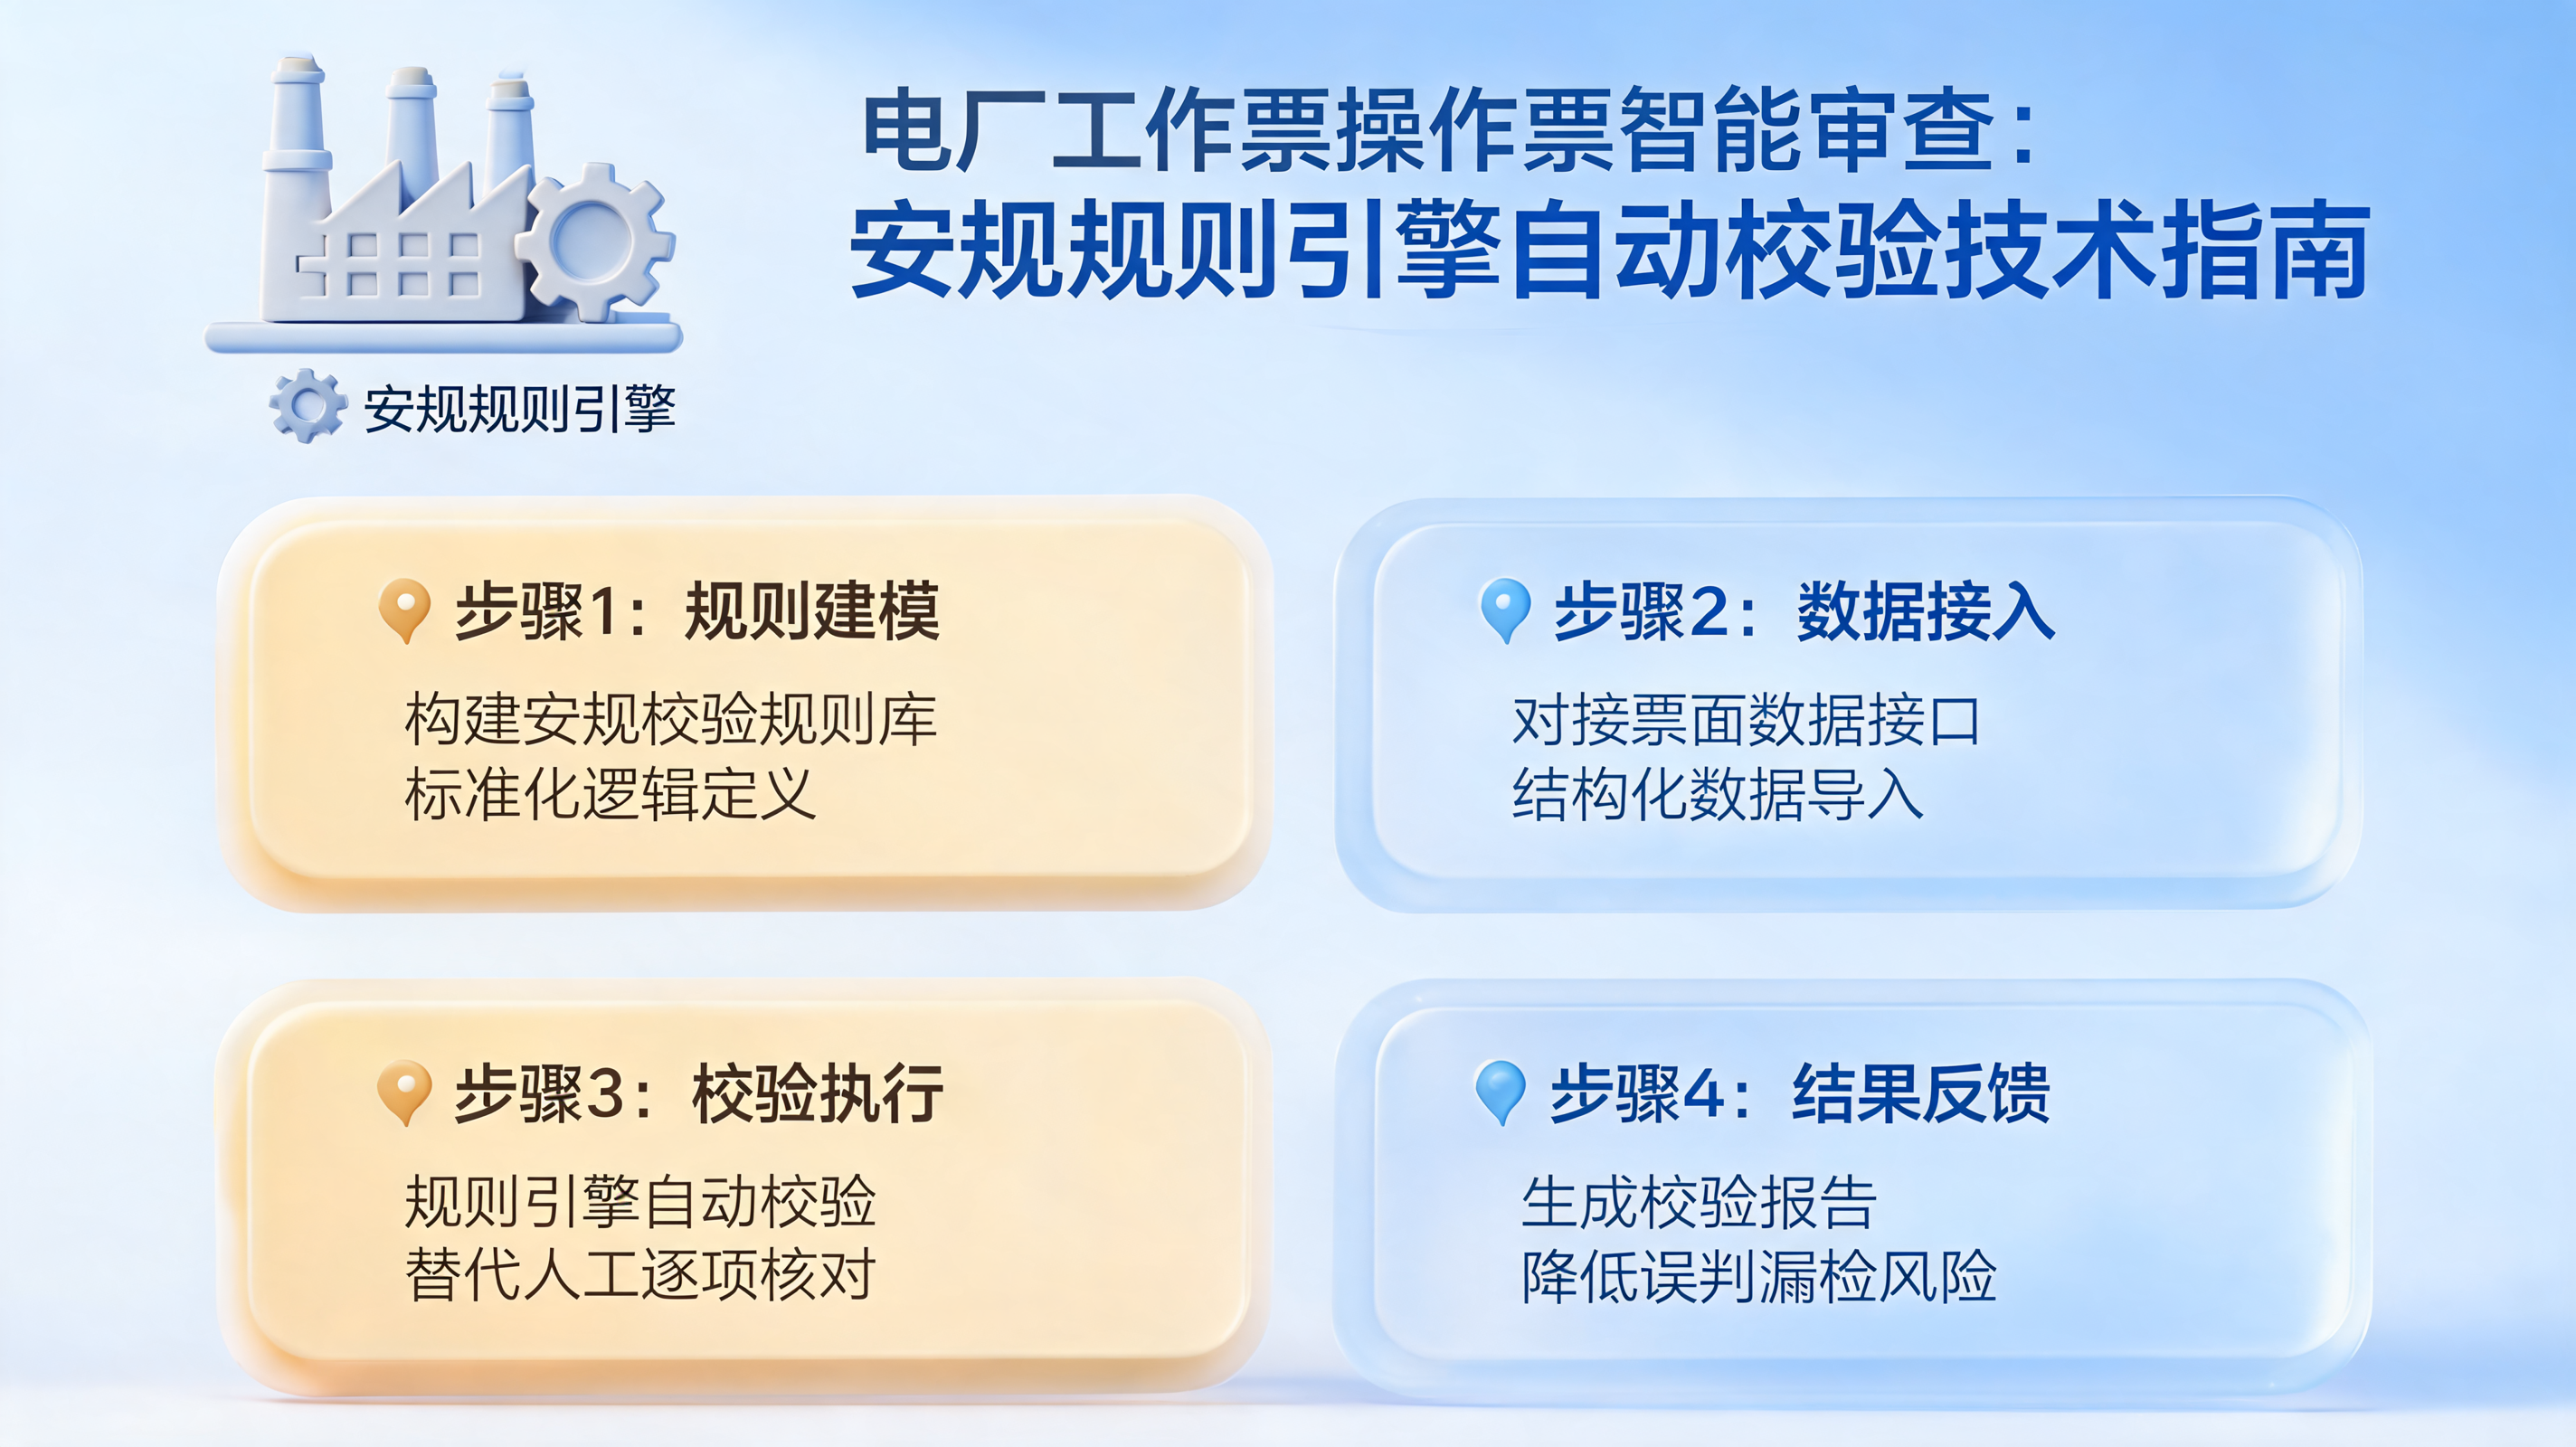
电厂工作票与操作票的智能审查,核心是通过安规规则引擎对票面内容进行自动校验,替代人工逐项核对,降低误判与漏检风险。本文从规则建模、数据接入、校验执行到结果反馈,分步说明如何落地一套可维护的自动校验系统。
一、理解智能审查的基本流程
智能审查并非直接让大模型“读票”,而是将安规条款拆解为可执行的逻辑判断。典型流程如下:
- 从工作票/操作票系统获取结构化或半结构化数据。
- 将票面字段映射到规则引擎的输入事实。
- 规则引擎加载安规规则集,逐条匹配并触发校验。
- 输出违规项、风险等级与建议修正内容。
- 将审查结果回写至票面系统或推送至责任人。
核心价值在于:规则可版本化、可追溯,审查结果一致,不受人员经验波动影响。
二、安规规则引擎的选型与建模
规则引擎建议选择支持声明式规则、优先级和冲突消解的开源方案,例如 Drools、Easy Rules 或 JSON 驱动的轻量引擎。建模时注意以下三点:
- 规则粒度:一条安规条款可拆成多条原子规则。例如“停电作业必须验电”可拆为“是否停电”“是否验电”“验电位置是否匹配”三个判断。
- 事实模型:定义票面对象,如
WorkTicket、OperationStep、Equipment,每个对象包含必要字段。 - 规则优先级:安全等级高的规则优先执行,如“带电作业未接地”应比“签名缺失”更早触发。
示例规则片段(伪代码):
{
  "id": "RULE-001",
  "priority": 100,
  "condition": "ticket.type == '停电作业' && ticket.verifyElectric == false",
  "action": "raiseViolation('未执行验电', '高')"
}
三、票面数据的结构化接入
规则引擎需要干净的事实输入。常见接入方式:
- API 拉取:通过工作票系统提供的 REST 接口获取 JSON 数据,如
GET /api/tickets/{id}。 - 数据库视图:直接读取只读视图,避免影响生产库。
- 消息队列:票面状态变更时推送至 Kafka 或 RabbitMQ,触发实时审查。
字段映射时注意单位统一、枚举值标准化。例如“电压等级”统一为 kV 数值,“工作类型”映射为固定枚举。
四、核心校验规则示例
以下列出几类高频安规校验规则,可直接作为规则库起点:
- 人员资质:工作负责人是否具备对应资质,特种作业人员是否在有效期内。
- 时间逻辑:计划开始时间是否早于结束时间,操作票步骤时间是否顺序合理。
- 设备状态:停电范围是否覆盖所有检修设备,接地线编号是否与票面一致。
- 安全措施:是否遗漏“防止误合闸”“防止倒送电”等关键措施。
- 操作顺序:操作票中“验电”是否在“挂地线”之前,“送电”是否在“拆地线”之后。
每条规则应附带违规说明和修正建议,便于用户理解。
五、规则执行与冲突处理
规则引擎执行时可能触发多条规则,需处理冲突:
- 同一事实多规则命中:按优先级保留最高等级,其余合并为补充提示。
- 规则间依赖:如“验电”规则依赖“停电”规则的结果,可用规则流或阶段划分。
- 性能控制:对大批量票面审查,采用批量事实插入和并行执行,避免逐条查询数据库。
建议设置审查超时时间,例如 500ms,超时后降级为人工复核。
六、审查结果反馈与闭环
审查结果不应只输出“通过/不通过”,而应提供可操作信息:
- 违规定位:精确到票面字段或步骤序号。
- 风险等级:高、中、低,对应不同处理流程。
- 建议修正:给出合规写法或补充措施。
- 回写接口:通过
POST /api/tickets/{id}/review回写审查结论。
闭环还包括规则版本管理:每次安规更新后,规则库需同步修订并记录变更日志,确保审查依据可追溯。
七、部署与运维要点
- 规则热加载:支持不重启引擎更新规则,减少停机。
- 日志与审计:记录每次审查的输入、命中规则、输出结果,保留至少 6 个月。
- 灰度发布:新规则先在小范围票面中试运行,对比人工审查结果。
- 监控告警:规则执行失败率、平均耗时、违规率突增时触发告警。
八、常见问题与规避建议
- 规则过于严格:导致大量误报,建议先以“提示”模式运行,再逐步转为“阻断”。
- 票面数据缺失:规则引擎无法判断,应输出“数据不足,需人工确认”,而非默认通过。
- 规则冲突:定期审查规则集,消除互斥条件。
- 性能瓶颈:避免在规则中执行远程调用或复杂计算,必要时预计算事实。
智能审查不是替代安规执行,而是将重复性核对自动化,让人员聚焦于现场风险判断。规则引擎的维护需要安规专家与开发人员持续协作,才能保持校验准确与实用。