私募尽调智能体:股权穿透+尽调报告自动化生成技术指南
私募尽调智能体是一套将股权穿透计算与尽调报告自动生成整合为流水线的技术系统,核心价值在于把原本需要数天的人工核查与文档撰写压缩到分钟级。本文从数据接入、穿透算法、报告模板引擎到部署运维,逐步拆解实现路径。
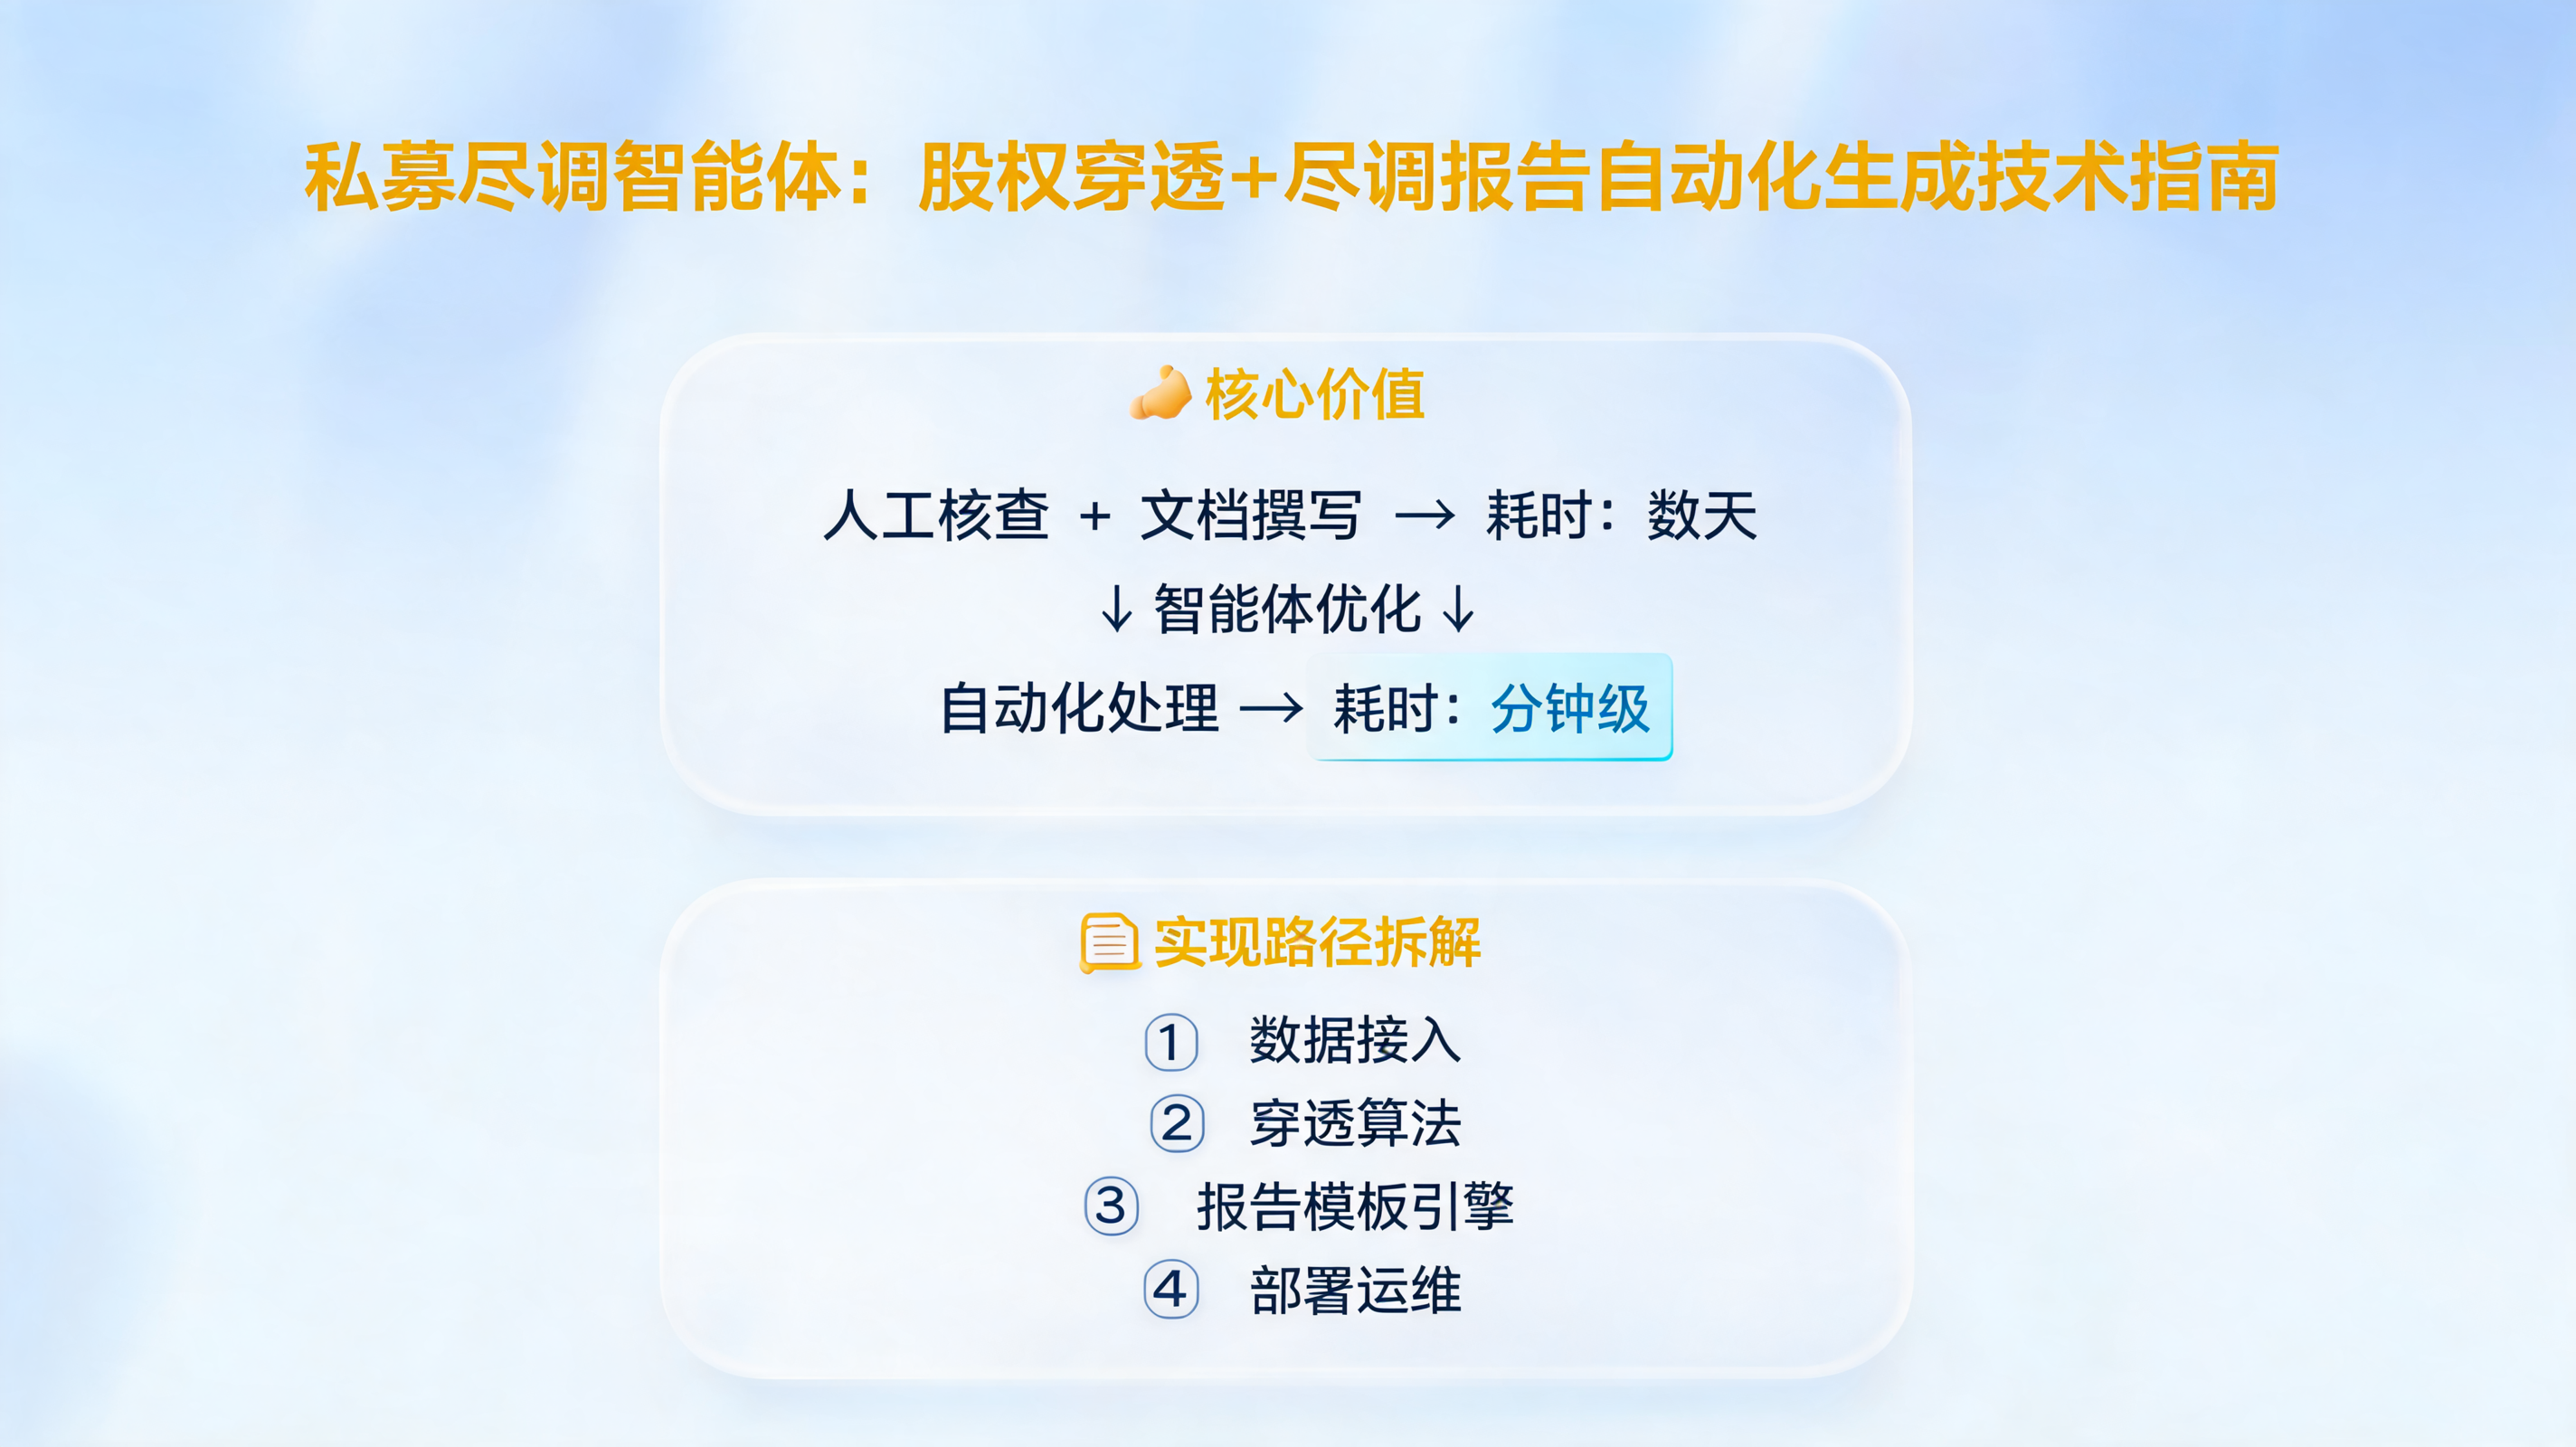
一、整体架构与数据流
系统分为四层:数据接入层、股权穿透计算层、报告生成层、输出与审计层。
数据流如下:
外部数据源 → 数据清洗 → 股权图谱构建 → 穿透计算 → 结构化结果 → 模板渲染 → 尽调报告(PDF/DOCX)关键路径:
- 数据接入:
/api/v1/ingest - 穿透计算:
/api/v1/penetrate - 报告生成:
/api/v1/report/generate - 健康检查:
/healthz
建议将穿透计算与报告生成拆分为独立服务,通过消息队列(如 RabbitMQ 或 Redis Stream)解耦,避免长任务阻塞 API 响应。
二、股权穿透的数据建模
股权穿透需要处理三类实体:企业、自然人、投资关系。建议使用图数据库(Neo4j 或 NebulaGraph)存储,节点属性包括统一社会信用代码、姓名、证件号哈希;边属性包括持股比例、认缴金额、投资层级。
核心关系模型:
// 创建企业节点
MERGE (c:Company {creditCode: "91310000MA1FL1234X"})
SET c.name = "示例投资管理有限公司"

// 创建自然人节点
MERGE (p:Person {idHash: "sha256:abc123..."})
SET p.name = "张三"

// 创建持股关系
MATCH (p:Person {idHash: "sha256:abc123..."})
MATCH (c:Company {creditCode: "91310000MA1FL1234X"})
MERGE (p)-[r:HOLDS {ratio: 0.35, amount: 3500000}]->(c)
穿透计算时,从目标企业出发,沿 HOLDS 边反向遍历至自然人节点或国资主体。注意设置最大深度(通常 5-10 层)和最小持股阈值(如 5%),避免路径爆炸。
三、穿透算法实现要点
穿透计算本质是带权重的图遍历。推荐使用迭代式广度优先搜索,每层累乘持股比例,并记录路径。
伪代码示例:
def penetrate(start_company_id, max_depth=8, min_ratio=0.05):
    results = []
    queue = [(start_company_id, 1.0, [])]
    while queue:
        node_id, current_ratio, path = queue.pop(0)
        if len(path) >= max_depth:
            continue
        for holder, ratio in get_holders(node_id):
            new_ratio = current_ratio * ratio
            if new_ratio < min_ratio:
                continue
            new_path = path + [(holder, new_ratio)]
            if is_natural_person(holder) or is_state_owned(holder):
                results.append(new_path)
            else:
                queue.append((holder, new_ratio, new_path))
    return results
关键注意点:
- 循环持股需检测路径中是否已出现当前节点,避免死循环。
- 同一自然人通过多条路径持股时,需合并计算最终受益比例。
- 对“一致行动人”“代持”等特殊情形,建议预留人工标注入口,算法不自动推断。
四、尽调报告模板引擎
报告生成推荐采用“结构化数据 + 模板”的方案。模板使用 Jinja2 或 Docxtemplater,输出格式支持 PDF 和 DOCX。
模板中可嵌入的条件块示例:
{% if penetration_paths | length > 0 %}
## 股权穿透结果
{% for path in penetration_paths %}
- 路径 {{ loop.index }}:{{ path | join(" → ") }},最终受益比例 {{ path[-1][1] | round(4) }}
{% endfor %}
{% else %}
未发现达到披露阈值的穿透路径。
{% endif %}报告章节建议固定为:企业基本信息、股东结构、穿透至最终受益人、对外投资、风险提示、数据来源与核查时间。每份报告生成时记录模板版本号和输入数据快照哈希,便于审计追溯。
五、自动化流水线与任务调度
将上述模块串联为可重复执行的流水线。推荐使用 Airflow 或 Prefect 定义 DAG:
ingest_task >> build_graph_task >> penetrate_task >> generate_report_task >> notify_task每个任务输出写入对象存储(如 MinIO),路径格式:
/reports/{company_credit_code}/{timestamp}/report.pdf
/reports/{company_credit_code}/{timestamp}/raw_data.json
通知任务通过 Webhook 或邮件发送报告链接。若穿透计算耗时超过 30 秒,建议改为异步任务,前端轮询 /api/v1/report/status/{task_id}。
六、部署与运维建议
- 图数据库与关系型数据库分离部署,图库内存建议不低于 16GB。
- 报告生成服务无状态,可水平扩展;穿透计算服务因图遍历较吃内存,建议限制并发数。
- 所有外部数据源接入需配置超时与重试,避免单点故障拖垮流水线。
- 日志中禁止输出自然人证件号明文,使用哈希或掩码。
- 定期对穿透结果做抽样人工复核,偏差超过 1% 时触发告警。
七、常见问题与排查
穿透结果为空:检查目标企业统一社会信用代码是否正确,以及图库中是否存在该节点。可执行 MATCH (c:Company {creditCode: "..."}) RETURN c 验证。
报告生成失败:查看模板中引用的字段是否在结构化结果中存在。建议在渲染前做一次 schema 校验。
任务堆积:检查穿透计算服务的 CPU 与内存使用率,适当降低单次遍历深度或提高最小持股阈值。
数据不一致:确认数据接入任务是否完整执行,对比原始数据源与图库中的边数量。